AI viết code sai phiên bản là lỗi mô hình AI sinh ra mã chạy đúng với bản thư viện cũ nhưng hỏng trên bản bạn đang dùng. Nguyên nhân chính là dữ liệu huấn luyện dừng ở một thời điểm, trong khi thư viện tiếp tục đổi tên hàm, đổi cách gọi và xoá tính năng. Cách khắc phục gồm bốn việc: ghi rõ phiên bản trong prompt, cho AI đọc tệp khai báo phiên bản của dự án, bắt mã chạy thử bằng máy, và chỉ vá phần sai thay vì viết lại.
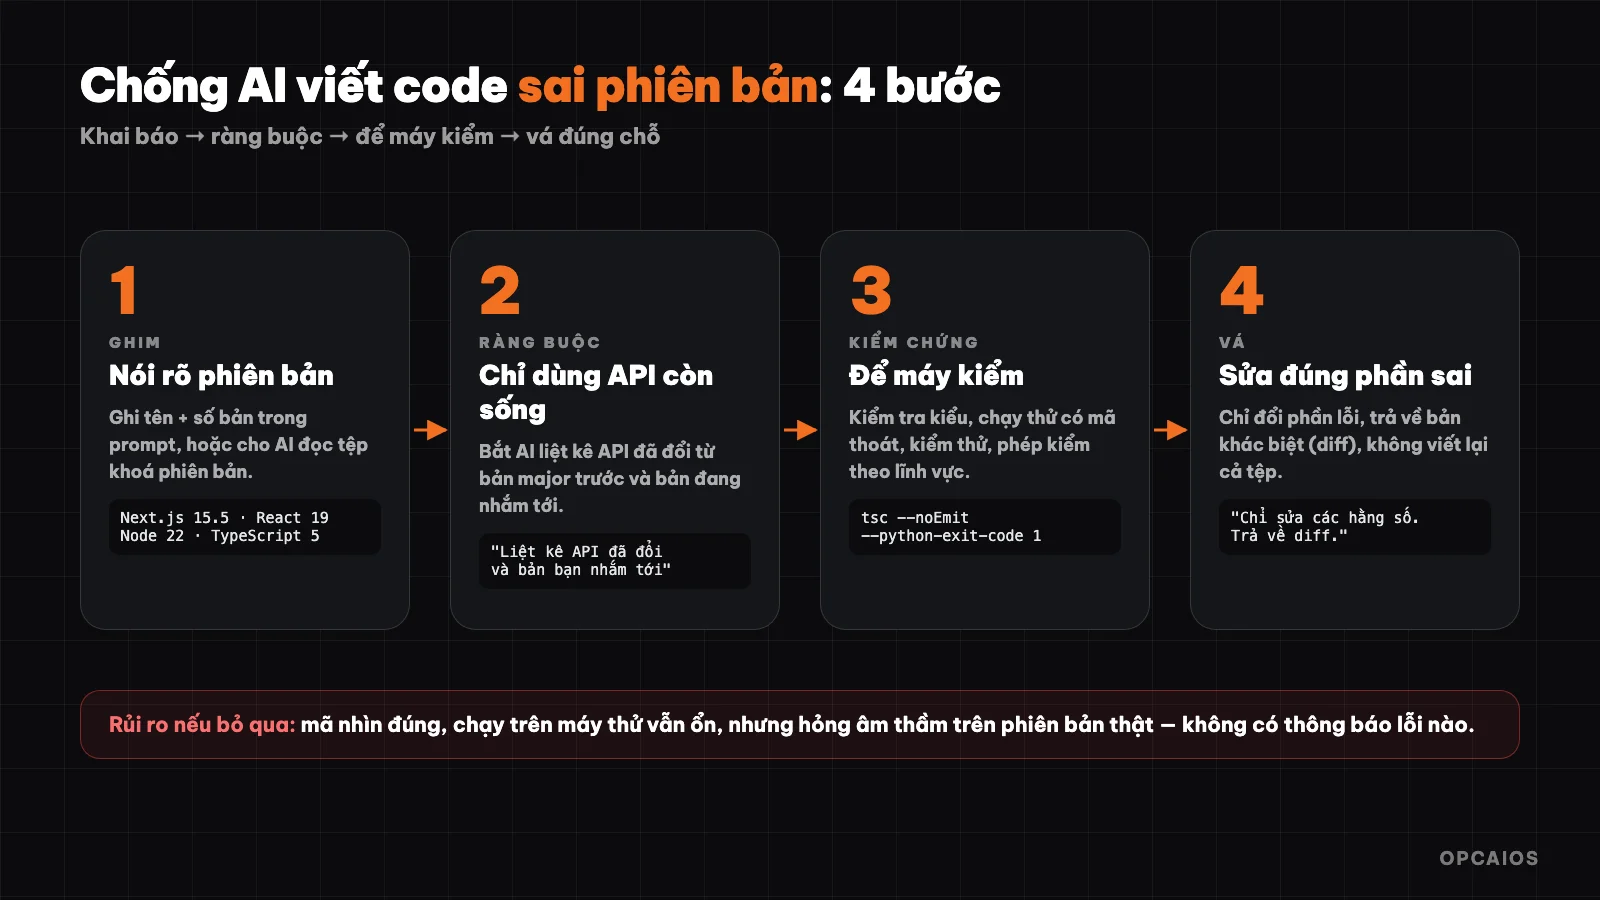
Bốn bước giữ cho mã do AI viết khớp đúng phiên bản đang dùng. Sơ đồ: OPCAIOS.
AI viết code sai phiên bản là gì?
Lỗi sai phiên bản xảy ra khi mô hình AI viết mã dựa trên cách dùng của một bản thư viện cũ, còn dự án của bạn chạy bản mới hơn. Mã nhìn hợp lý, đúng cú pháp, đúng tên hàm từng tồn tại, nhưng chạy ra lỗi hoặc, tệ hơn, chạy ra kết quả sai mà không báo lỗi.
Ba dạng thường gặp:
- Hàm bị xoá hoặc đổi tên: lệnh cũ không còn trong bản mới.
- Giá trị mặc định đổi: cùng một lệnh nhưng hành vi khác đi.
- Cách gọi đổi từ đồng bộ sang bất đồng bộ: mã thiếu bước chờ nên dữ liệu về rỗng.
Vì mã trông đúng, người đọc lướt qua dễ bỏ sót. Lỗi chỉ lộ ra khi chạy thật, đôi khi sau khi đã đưa lên máy chủ.
Ví dụ cụ thể: một lập trình viên nhờ ChatGPT hoặc Claude viết đoạn lấy cookie đăng nhập cho website Next.js. Đoạn mã dùng cách gọi đồng bộ của bản cũ, trong khi dự án đã lên Next.js 15 nơi hàm này trở thành bất đồng bộ. Trang vẫn dựng được trên máy cá nhân với dữ liệu thử, nhưng khách thật đăng nhập thì nhận về giá trị rỗng. Đây là lý do lỗi phiên bản được xếp vào nhóm lỗi âm thầm: không có thông báo đỏ nào xuất hiện để cảnh báo.
Vì sao AI hay viết code cho phiên bản cũ?
Mô hình AI học từ khối dữ liệu có hạn chót, và lượng tài liệu về phiên bản cũ luôn nhiều hơn phiên bản mới. Một thư viện ra bản lớn mới vào tháng này thì bài hướng dẫn, câu hỏi trên diễn đàn và mã nguồn mẫu viết cho bản đó chỉ có vài tuần, trong khi bản cũ đã có nhiều năm tích luỹ. Khi viết mã, mô hình nghiêng về cách làm xuất hiện nhiều nhất trong dữ liệu đã học, và cách làm đó thường thuộc về bản cũ. Thêm vào đó, mô hình không tự biết hôm nay là ngày nào hay thư viện đang ở bản bao nhiêu, trừ khi người dùng hoặc công cụ cung cấp thông tin đó. Vì vậy, thiếu thông tin về phiên bản trong yêu cầu đồng nghĩa với việc mô hình chọn bản phổ biến nhất trong trí nhớ, không phải bản bạn đang chạy.
Ví dụ do tác giả @0xCodio nêu về Blender, phần mềm dựng 3D mã nguồn mở có giao diện lập trình Python: tên định danh của bộ render EEVEE đổi từ BLENDER_EEVEE sang BLENDER_EEVEE_NEXT ở bản 4.2, rồi đổi ngược lại thành BLENDER_EEVEE ở bản 5.0. Mô hình đã học đúng lần đổi tên giữa chừng lại sai ở bản mới nhất, còn mô hình chưa từng học lần đổi tên đó lại đúng một cách ngẫu nhiên. Vấn đề nằm ở việc nhắm sai đích, không phải ở khả năng suy luận.
Mức độ nghiêm trọng đến đâu?
Theo bài kiểm thử mà @0xCodio dẫn lại, một bộ 30 nhiệm vụ viết mã Blender được chạy thật trên bốn bản Blender với mười mô hình, tổng cộng 1.190 câu trả lời được chấm bằng cách thực thi mã. Số liệu này là của tác giả gốc, OPCAIOS chưa kiểm chứng độc lập, nhưng cho thấy xu hướng rõ:
| Chỉ số | Blender 3.6 | Blender 5.0 |
|---|---|---|
| Tỉ lệ mã chạy được | 91% | 70% |
| Tỉ lệ mô hình nói đúng điều gì đã thay đổi | 81% | 35% |
Ngoài ra, ba nhóm nhiệm vụ (compositor, bộ giải boolean, sequencer) bị 0 điểm ở mọi mô hình trên Blender 5.0. Điểm đáng chú ý: tỉ lệ mô hình tự nhận ra mình đang dùng API cũ giảm mạnh hơn tỉ lệ mã chạy được, nghĩa là AI không tự cảnh báo khi viết sai phiên bản.
Làm sao ghim phiên bản trong prompt?
Ghim phiên bản là ghi rõ tên và số phiên bản của mọi công cụ liên quan ngay đầu yêu cầu, rồi buộc AI nêu lại phiên bản đã dùng cho từng API quan trọng. Hai thao tác này biến một điều ngầm hiểu thành điều có thể kiểm tra.
Mẫu đầu prompt dùng được cho hầu hết dự án:
Môi trường: Next.js 15.5, React 19, Node 22, TypeScript 5.
Chỉ dùng API còn có trong các phiên bản trên.
Sau đoạn mã, liệt kê mọi API đã đổi từ bản major trước
và ghi rõ bạn đang nhắm tới bản nào.
Với Claude Code hay công cụ tương tự có đọc được thư mục dự án, cách tốt hơn là để AI tự đọc package.json, requirements.txt hoặc tệp khoá phiên bản. Phiên bản thật nằm trong tệp, nên AI không phải đoán và con người không phải gõ lại. Với công cụ không có tệp khai báo như Blender, lệnh blender --version hoặc python --version cho ra số phiên bản chính xác để dán vào đầu yêu cầu. Cách làm này tốn chưa đến một phút cho mỗi phiên làm việc, nhưng loại bỏ nguyên nhân phổ biến nhất của lỗi sai phiên bản: AI chọn một bản mặc định trong trí nhớ thay vì bản dự án thật sự dùng.
Làm sao để máy kiểm chứng thay vì mắt người?
Kiểm chứng bằng máy nghĩa là mỗi đoạn mã AI viết phải đi qua một phép thử tự động, và phép thử dừng quy trình khi sai. Con người xem lại mã rất dễ bỏ sót lỗi phiên bản vì mã trông hợp lý, còn máy thì chạy thử rồi báo thẳng.
Các lớp kiểm tra nên có, từ rẻ đến đắt:
- Kiểm tra kiểu và biên dịch: bắt hàm không tồn tại và tham số sai ngay trước khi chạy.
- Chạy thử có mã thoát: script lỗi phải khiến hệ thống tự động báo đỏ, không báo xanh.
- Kiểm thử đơn vị cho phần quan trọng: kết quả đúng với dữ liệu mẫu.
- Phép kiểm đếm theo đặc thù lĩnh vực: ví dụ với mô hình 3D để in, kiểm tra cạnh không kín và mặt suy biến bằng mã, vì ảnh render vẫn đẹp dù vật thể hỏng.
Nguyên tắc chung: để máy kiểm những gì máy kiểm được, và chỉ dùng mắt người cho phần máy không đo được. Quy trình chi tiết cho Blender có trong bài AI viết Python cho Blender.
Có ví dụ thực tế nào khi nâng cấp lên Next.js 15?
Ví dụ gần gũi với người làm web: khi website opcaios.org nâng cấp lên Next.js 15 và React 19, đội ngũ gặp đúng loại lỗi này. Theo tài liệu nâng cấp chính thức của Next.js, từ phiên bản 15 các hàm như cookies() và tham số params của trang trở thành bất đồng bộ, phải dùng await. Mã mẫu AI sinh ra theo thói quen cũ vẫn trông đúng, chạy thử thì lỗi hoặc cho giá trị rỗng.
Cách xử lý hiệu quả là hai bước: khai báo phiên bản Next.js trong prompt, và chạy trình kiểm tra kiểu TypeScript sau mỗi lần AI sửa. Trình kiểm tra kiểu bắt phần lớn chỗ thiếu await trước khi mã lên máy chủ. Đây là trải nghiệm của chính chúng tôi khi nâng cấp, không phải số liệu thống kê chung.
Khi nào nên cho AI tra tài liệu thay vì tự nhớ?
Cho AI tra tài liệu chính thức là hợp lý khi thư viện đổi nhanh hoặc vừa ra bản lớn. Thay vì dựa vào trí nhớ đã cũ, AI đọc trang tài liệu hiện hành rồi mới viết mã.
Cách làm phổ biến là dùng MCP, chuẩn kết nối giúp ứng dụng AI đọc dữ liệu và công cụ bên ngoài. Một số nhà cung cấp thư viện có máy chủ MCP trả về tài liệu theo đúng phiên bản. Nếu chưa quen, đọc bài MCP là gì? trước. Lưu ý bảo mật: máy chủ MCP chạy mã hoặc đọc dữ liệu thật, nên chỉ cài từ nguồn tin cậy và cấp quyền chỉ đọc trước. Nếu không dùng MCP, cách thủ công vẫn hiệu quả: mở trang hướng dẫn nâng cấp của thư viện, dán phần liệt kê thay đổi phá vỡ tương thích (breaking changes) vào yêu cầu, rồi bảo AI áp dụng đúng danh sách đó. Danh sách thay đổi do nhà phát triển viết là nguồn đáng tin hơn trí nhớ của mô hình.
Checklist nào giúp mã AI viết khớp phiên bản?
Checklist là danh sách bảy việc làm theo thứ tự để mã do AI viết khớp đúng phiên bản đang dùng, áp dụng cho Next.js, Python, Blender hay bất kỳ công cụ nào. Mỗi bước tốn vài phút nhưng chặn được một nhóm lỗi cụ thể, từ gọi sai hàm cho tới kết quả sai âm thầm:
- Ghi phiên bản chính xác của mọi thư viện trong prompt, hoặc cho AI đọc tệp khoá phiên bản.
- Yêu cầu AI liệt kê API đã đổi và bản đang nhắm tới.
- Đặt cấu hình để lỗi thật sự dừng quy trình.
- Chạy trình kiểm tra kiểu hoặc biên dịch sau mỗi lần sửa.
- Viết ít nhất một phép kiểm tự động cho kết quả quan trọng.
- Khi sai, yêu cầu AI vá đúng phần sai và trả về bản khác biệt, không viết lại cả tệp.
- Với thư viện mới hoặc đổi nhanh, cho AI tra tài liệu hiện hành trước khi viết.
Câu hỏi thường gặp
Vì sao AI viết code bị lỗi dù trông rất đúng?
Mã nhìn đúng vì khớp với cách dùng phổ biến trong dữ liệu AI đã học. Lỗi chỉ xuất hiện khi chạy trên phiên bản mới hơn, nơi tên hàm hoặc cách gọi đã đổi.
Ghi phiên bản trong prompt có đủ không?
Chưa đủ. Ghi phiên bản giúp giảm lỗi nhưng không loại bỏ hoàn toàn. Cần thêm bước chạy thử hoặc kiểm tra kiểu để máy xác nhận mã thật sự chạy trên phiên bản đó.
Nên cho AI đọc tài liệu hay tin vào trí nhớ của mô hình?
Với thư viện ổn định, trí nhớ của mô hình thường đủ. Với thư viện vừa ra bản lớn hoặc đổi nhanh, nên cho AI đọc tài liệu hiện hành, ví dụ qua MCP hoặc dán trang tài liệu liên quan vào yêu cầu.
Lỗi sai phiên bản có chỉ xảy ra với một mô hình AI cụ thể không?
Không. Theo bài kiểm thử trên mười mô hình mà @0xCodio dẫn, xu hướng tụt điểm trên phiên bản mới xuất hiện ở nhiều mô hình khác nhau. Chọn mô hình khác không thay thế được việc ghim phiên bản và kiểm chứng.
Người không chuyên code có cần quan tâm không?
Có, nếu bạn nhờ AI viết script tự động hoá cho công việc. Hãy hỏi AI đang nhắm phiên bản nào và yêu cầu chạy thử trước khi dùng thật. Muốn tìm hiểu cách dùng AI an toàn trong doanh nghiệp, xem khoá đào tạo ứng dụng AI.
Nguồn: số liệu benchmark và ví dụ Blender từ bài của @0xCodio trên X (11/10/2026), chưa kiểm chứng độc lập; ví dụ Next.js 15 là trải nghiệm của OPCAIOS.
Để lại bình luận
Email của bạn sẽ không hiển thị công khai. Bình luận sẽ hiển thị sau khi được duyệt.