


LLM là gì? LLM (Large Language Model, mô hình ngôn ngữ lớn) là một mô hình học máy, thường là mạng nơ-ron, được huấn luyện trên lượng văn bản rất lớn để làm các việc về ngôn ngữ như viết, tóm tắt, dịch và phân tích văn bản. Phần lớn LLM, theo Wikipedia (đọc ngày 24/10/2026), dùng kiến trúc Transformer, được học cách dự đoán token tiếp theo rồi tinh chỉnh để làm theo chỉ dẫn; các chatbot như ChatGPT, Claude, Gemini, Grok, Qwen và DeepSeek đều chạy trên LLM. LLM mạnh ở việc xử lý ngôn ngữ nhưng có giới hạn rõ: có thể "bịa" (hallucination), bị giới hạn bởi cửa sổ ngữ cảnh và phản ánh thiên lệch của dữ liệu huấn luyện.
Bài viết đi qua: 1) cách hoạt động (token, Transformer, huấn luyện); 2) cửa sổ ngữ cảnh; 3) giới hạn; 4) cách mở rộng bằng RAG và công cụ; 5) cách dùng an toàn; 6) kinh nghiệm của OPCAIOS. Ví dụ, ChatGPT là sản phẩm chatbot, còn LLM là mô hình chạy bên dưới.
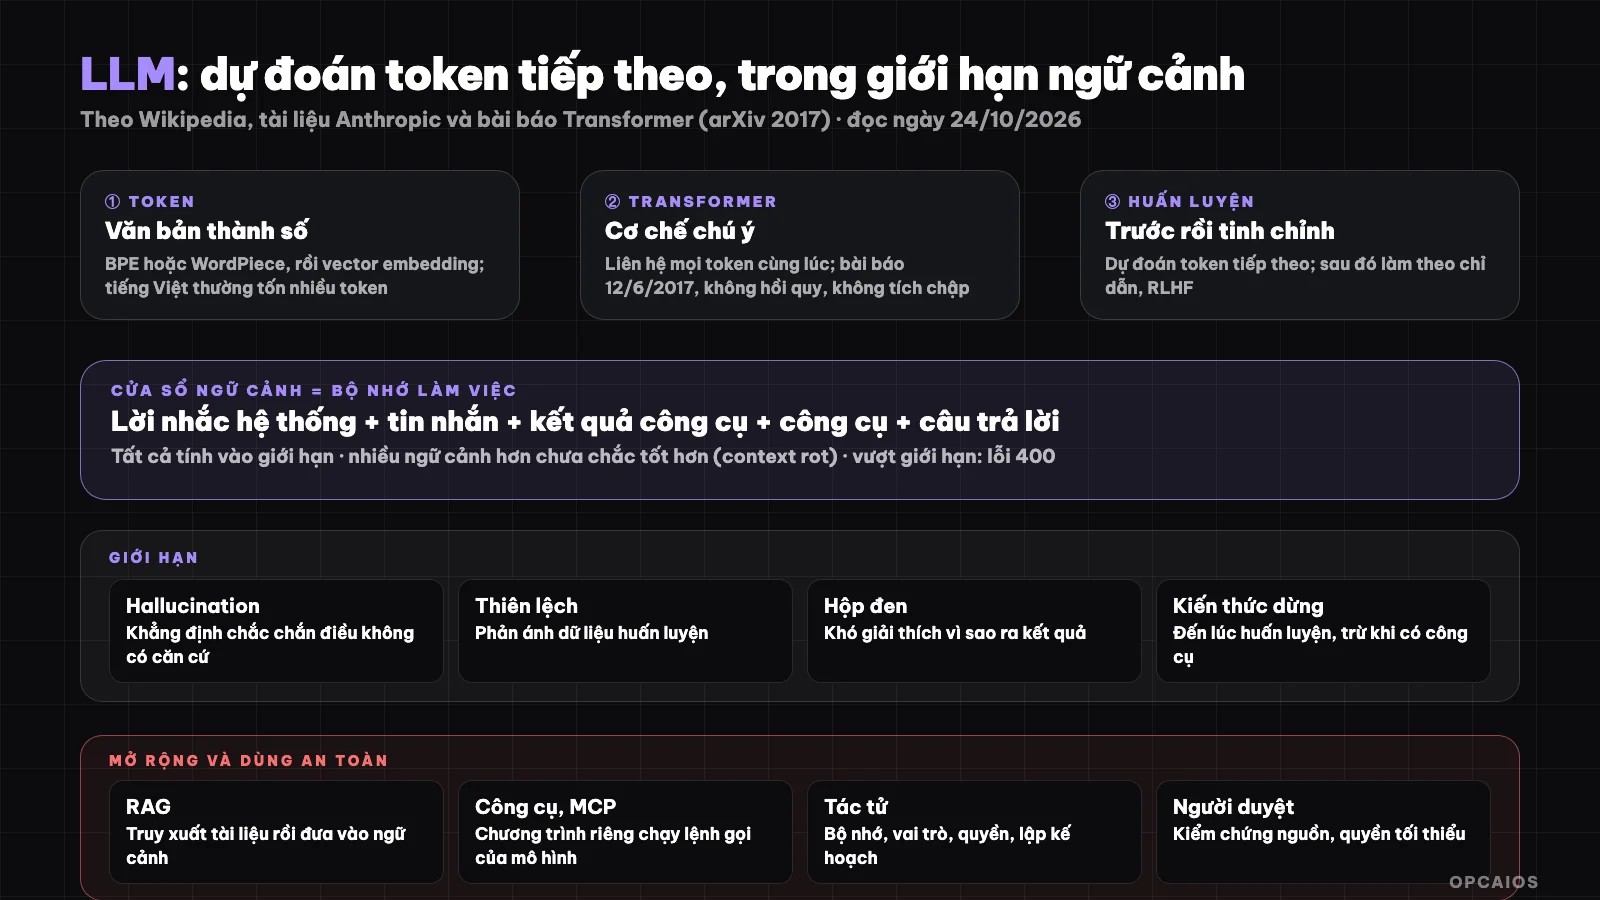
LLM dự đoán token tiếp theo trong giới hạn cửa sổ ngữ cảnh; RAG và công cụ giúp nó dùng dữ liệu bên ngoài. Sơ đồ: OPCAIOS.
LLM là gì và khác phần mềm thông thường ở đâu?
LLM khác phần mềm thông thường ở chỗ không chạy theo quy tắc do lập trình viên viết sẵn, mà học các mẫu ngôn ngữ từ dữ liệu. Phần mềm thông thường, như máy tính bỏ túi hay bảng tính, luôn cho cùng một kết quả với cùng một đầu vào. LLM thì sinh câu trả lời bằng cách chọn lần lượt từng token có khả năng cao nhất theo ngữ cảnh, theo Wikipedia (đọc ngày 24/10/2026). Vì vậy cùng một câu hỏi có thể cho các câu trả lời hơi khác nhau, và câu trả lời trôi chảy chưa chắc đã đúng. Ví dụ, khi hỏi ChatGPT hay Claude về một con số cụ thể không có trong ngữ cảnh, mô hình có thể đưa ra con số nghe hợp lý nhưng sai. Đầu tiên, hãy coi đầu ra là bản nháp. Tiếp theo, đối chiếu số liệu với nguồn gốc. Cuối cùng, giữ người duyệt cho nội dung quan trọng. Lý do chung là mọi kết quả quan trọng của LLM cần được kiểm chứng trước khi dùng.
LLM hoạt động như thế nào?
Token và embedding
Theo Wikipedia, văn bản được chuyển thành các số nguyên gọi là token ID (bằng các phương pháp như byte-pair encoding hay WordPiece) rồi thành vector embedding để mạng nơ-ron xử lý. Một token có thể là một từ, một phần của từ hoặc một ký tự; vì vậy văn bản tiếng Việt thường tốn nhiều token hơn số từ nhìn thấy.
Transformer là gì và cơ chế chú ý hoạt động ra sao?
Transformer là kiến trúc mạng nơ-ron chỉ dựa vào cơ chế chú ý (attention), không dùng mạng hồi quy hay tích chập, được giới thiệu trong bài báo "Attention Is All You Need" (Vaswani và cộng sự, đăng lên arXiv ngày 12/6/2017). Bài báo có ba ý chính: 1) cơ chế chú ý cho phép liên hệ mọi token trong chuỗi với nhau cùng lúc, bất kể khoảng cách; 2) theo tóm tắt của bài báo, Transformer dễ song song hoá và huấn luyện nhanh hơn, đạt 28,4 BLEU trên bài dịch Anh-Đức WMT 2014 và 41,8 BLEU trên Anh-Pháp sau 3,5 ngày với tám GPU; 3) từ nền tảng ấy có GPT, BERT và phần lớn mô hình ngày nay.
Ngoài ra, một số mô hình dùng kiến trúc hỗn hợp chuyên gia (mixture of experts), mỗi đầu vào chỉ đi qua một tập mạng con để giảm chi phí suy luận. Ví dụ, khi dịch một câu dài, cơ chế chú ý giúp từ ở cuối câu liên hệ trực tiếp với từ ở đầu câu thay vì đi qua từng bước trung gian.
Huấn luyện mô hình ngôn ngữ gồm những giai đoạn nào?
Huấn luyện mô hình ngôn ngữ là quá trình gồm hai giai đoạn chính, theo Wikipedia (đọc ngày 24/10/2026).
- Bước 1, huấn luyện trước (pretraining): mô hình học dự đoán token tiếp theo trên tập dữ liệu rất lớn đã làm sạch (loại dữ liệu kém, trùng lặp, độc hại).
- Bước 2, tinh chỉnh: dạy mô hình làm theo chỉ dẫn và hành xử hữu ích, gồm tinh chỉnh theo chỉ dẫn có giám sát, học tăng cường từ phản hồi của con người (RLHF, dùng mô hình phần thưởng học từ sở thích của người đánh giá) hoặc các phương pháp như constitutional AI.
Chi phí huấn luyện rất cao. Wikipedia dẫn ước tính khoảng $50.000 cho GPT-2 (2019) và khoảng $8 triệu cho PaLM 540B (2022), và con số chỉ là ước tính. Các "quy luật mở rộng" cho thấy hiệu năng tăng theo sức tính toán, số tham số và dữ liệu. Ví dụ, cùng một kiến trúc, mô hình có nhiều tham số và dữ liệu hơn thường đạt hiệu năng cao hơn, nhưng chi phí tăng theo.
Mô hình suy luận
Wikipedia ghi nhận chain-of-thought prompting (2022) giúp mô hình lập luận nhiều bước tốt hơn, và các mô hình suy luận như OpenAI o1 (tháng 9/2024) hay DeepSeek-R1 (tháng 1/2025) được huấn luyện để tạo phân tích từng bước trước khi trả lời. Đổi lại, phần "suy nghĩ" tốn thêm token và thời gian.
Cửa sổ ngữ cảnh là gì?
Cửa sổ ngữ cảnh là toàn bộ văn bản mô hình có thể tham chiếu khi tạo câu trả lời, kể cả chính câu trả lời, theo tài liệu của Anthropic (đọc ngày 24/10/2026); khác với kho dữ liệu huấn luyện, cửa sổ giống "bộ nhớ làm việc" hơn. Có bốn điều cần biết, theo thứ tự: 1) mọi thứ trong yêu cầu đều tính vào; 2) kích thước cửa sổ tuỳ mô hình; 3) vượt cửa sổ thì lỗi; 4) nhiều chưa chắc tốt hơn. Về điều thứ nhất, lời nhắc hệ thống, các tin nhắn, kết quả công cụ, hình ảnh, tài liệu, định nghĩa công cụ và phần mô hình sinh ra (kể cả phần suy nghĩ). Theo tài liệu hiện hành, nhiều mô hình Claude mới có cửa sổ 1 triệu token và một yêu cầu có thể sinh tối đa 128 nghìn token đầu ra; các mô hình khác có thể nhỏ hơn, nên hãy xem bảng so sánh mô hình hiện hành của nhà cung cấp bạn dùng. Nếu đầu vào đã vượt cửa sổ, API trả lỗi 400. Ví dụ, một hội thoại dài với tài liệu đính kèm có thể chạm giới hạn vì mọi tin nhắn cũ đều được tính lại ở mỗi lượt.
Giới hạn của LLM
- Hallucination: theo Wikipedia, mô hình có thể khẳng định chắc chắn những điều dữ liệu huấn luyện không hỗ trợ; cách giảm gồm truy xuất thông tin, suy luận tự động và tinh chỉnh.
- Thiên lệch: đầu ra phản ánh dữ liệu huấn luyện.
- Hộp đen: khó giải thích vì sao mô hình ra kết quả như vậy; nghiên cứu "giải thích cơ chế" đang cố làm rõ.
- Chưa học theo thời gian thực: kiến thức dừng ở thời điểm huấn luyện, trừ khi được cấp công cụ tìm kiếm hoặc dữ liệu.
- Chi phí và năng lượng: Wikipedia cũng nêu các lo ngại về bản quyền và điện năng.
- Tranh luận: giới nghiên cứu vẫn chia rẽ về việc mô hình có thực sự "hiểu" ngôn ngữ hay chỉ giỏi bắt chước mẫu.
Mở rộng LLM: RAG, công cụ và tác tử
Theo Wikipedia, RAG (retrieval-augmented generation) nhúng câu hỏi và tài liệu thành vector, tìm các đoạn gần nhất trong cơ sở dữ liệu vector rồi đưa vào ngữ cảnh để mô hình trả lời dựa trên đó; xem chi tiết trong RAG là gì?. Dùng công cụ (tool use) nghĩa là một chương trình riêng nhận lệnh gọi công cụ từ mô hình, chạy rồi trả kết quả lại; giao thức MCP chuẩn hoá cách kết nối này. Khi LLM được trao bộ nhớ, vai trò, quyền truy cập môi trường và khả năng lập kế hoạch, nó thành một tác tử (agent); xem cách dùng thực tế trong Vibe code là gì?.
Cách dùng LLM an toàn trong công việc
Dùng LLM an toàn nghĩa là cấp nguồn, kiểm chứng và giữ người duyệt, theo sáu bước sau.
- Bước 1, cung cấp nguồn: đưa tài liệu thật vào ngữ cảnh (RAG) thay vì để mô hình nhớ.
- Bước 2, kiểm chứng: số liệu, trích dẫn, đường dẫn, lệnh chạy cần đối chiếu nguồn.
- Bước 3, giữ người duyệt: nội dung công khai, gửi khách hàng hay thao tác không hoàn tác được phải qua người duyệt.
- Bước 4, quyền tối thiểu: chỉ cấp cho tác tử các công cụ và quyền cần thiết.
- Bước 5, không đưa bí mật vào lời nhắc: khoá API, mật khẩu, dữ liệu khách hàng nhạy cảm.
- Bước 6, chọn mô hình theo việc: việc đơn giản dùng mô hình nhỏ, rẻ; việc khó dùng mô hình mạnh, đo chi phí token.
Ví dụ, một bài viết gửi khách hàng nên được người duyệt đọc trước khi đăng, dù do Claude hay ChatGPT soạn. Quy trình áp dụng được cho các mô hình hiện hành năm 2026, kể cả mô hình của Google, OpenAI hay Anthropic.
Kinh nghiệm của OPCAIOS
OPCAIOS dùng LLM theo hai kiểu khác nhau, và quy trình thực tế gồm hai phần.
- Thứ nhất, mô hình sinh văn bản để soạn nháp: các bài viết, tóm tắt và bản dịch tiếng Anh đều đi qua hàng đợi chờ duyệt, và OPCAIOS không để mô hình tự xuất bản.
- Thứ hai, mô hình embedding nhỏ (e5-small) cho tìm kiếm ngữ nghĩa trong cơ sở dữ liệu vector: mô hình này biểu diễn văn bản thành vector chứ không sinh câu trả lời.
Bài học rút ra: LLM tăng tốc phần soạn thảo, nhưng phần kiểm chứng nguồn và quyết định đăng vẫn thuộc về người; mỗi bài của OPCAIOS ghi rõ những gì chưa đọc hoặc chưa kiểm chứng. Chúng tôi chưa tự huấn luyện hay tinh chỉnh LLM, và chưa có số đo chính thức về tỉ lệ sai của từng mô hình.
Câu hỏi thường gặp
LLM là gì?
Là mô hình học máy huấn luyện trên lượng lớn văn bản để hiểu và sinh ngôn ngữ, thường dùng kiến trúc Transformer và học bằng cách dự đoán token tiếp theo.
LLM khác ChatGPT thế nào?
ChatGPT là sản phẩm chatbot; LLM là mô hình chạy bên dưới. Claude, Gemini, Grok, Qwen, DeepSeek cũng là các chatbot hoặc họ mô hình dựa trên LLM.
Token là gì?
Là đơn vị nhỏ mà mô hình xử lý, có thể là một từ, một phần từ hoặc một ký tự. Giới hạn ngữ cảnh và chi phí thường tính theo token.
Vì sao LLM trả lời sai dù nghe rất chắc chắn?
Vì mô hình sinh văn bản có khả năng cao nhất theo mẫu đã học chứ không tra cứu sự thật. Hiện tượng này gọi là hallucination; giảm bằng cách cấp nguồn (RAG), kiểm chứng và người duyệt.
Cửa sổ ngữ cảnh càng lớn càng tốt?
Không hẳn, vì nhiều ngữ cảnh hơn không tự động tốt hơn. Tài liệu của Anthropic (đọc ngày 24/10/2026) ghi rằng khi số token tăng, độ chính xác và khả năng nhớ lại suy giảm, hiện tượng gọi là "context rot", nên chọn lọc cái gì đưa vào ngữ cảnh quan trọng ngang với dung lượng còn lại. Nhiều mô hình Claude mới có cửa sổ 1 triệu token, nhưng dung lượng lớn không bảo đảm mô hình chú ý đều mọi chỗ. Với hội thoại dài, tài liệu giới thiệu cơ chế nén ngữ cảnh phía máy chủ (compaction, dạng beta). Đầu tiên, chỉ đưa vào tài liệu liên quan trực tiếp. Tiếp theo, tóm tắt các lượt cũ khi hội thoại dài. Cuối cùng, kiểm tra lại các chi tiết quan trọng ở giữa văn bản dài. Ví dụ, thay vì dán cả 200 trang hợp đồng, hãy dán các điều khoản cần hỏi. Muốn học cách dùng LLM và tự động hoá an toàn cho doanh nghiệp, xem khoá đào tạo ứng dụng AI của OPCAIOS.
Nguồn: Wikipedia "Large language model" (đọc 100.000 ký tự đầu của bài, phần còn lại chưa đọc); tài liệu Anthropic "Context windows"; arXiv 1706.03762 "Attention Is All You Need", đọc ngày 24/10/2026. Con số chi phí huấn luyện lấy từ Wikipedia, là ước tính. Kích thước cửa sổ ngữ cảnh thay đổi theo mô hình và thời điểm. Kinh nghiệm là của OPCAIOS.
Để lại bình luận
Email của bạn sẽ không hiển thị công khai. Bình luận sẽ hiển thị sau khi được duyệt.