


robots.txt là gì? robots.txt là tệp văn bản đặt ở gốc website cho crawler biết URL nào chúng được phép truy cập, chủ yếu để quản lý lưu lượng crawl như tránh quá tải máy chủ hoặc bỏ qua trang trùng lặp. Theo tài liệu Google Search Central (đọc ngày 25/10/2026), nó không phải cơ chế giữ một trang khỏi Google: URL bị chặn vẫn có thể xuất hiện trong kết quả, không kèm mô tả, nếu có trang khác liên kết tới. Bài này giải thích robots.txt là gì, nó làm và không làm được gì, cách xử lý crawler AI, lỗi hay gặp và kinh nghiệm của OPCAIOS.
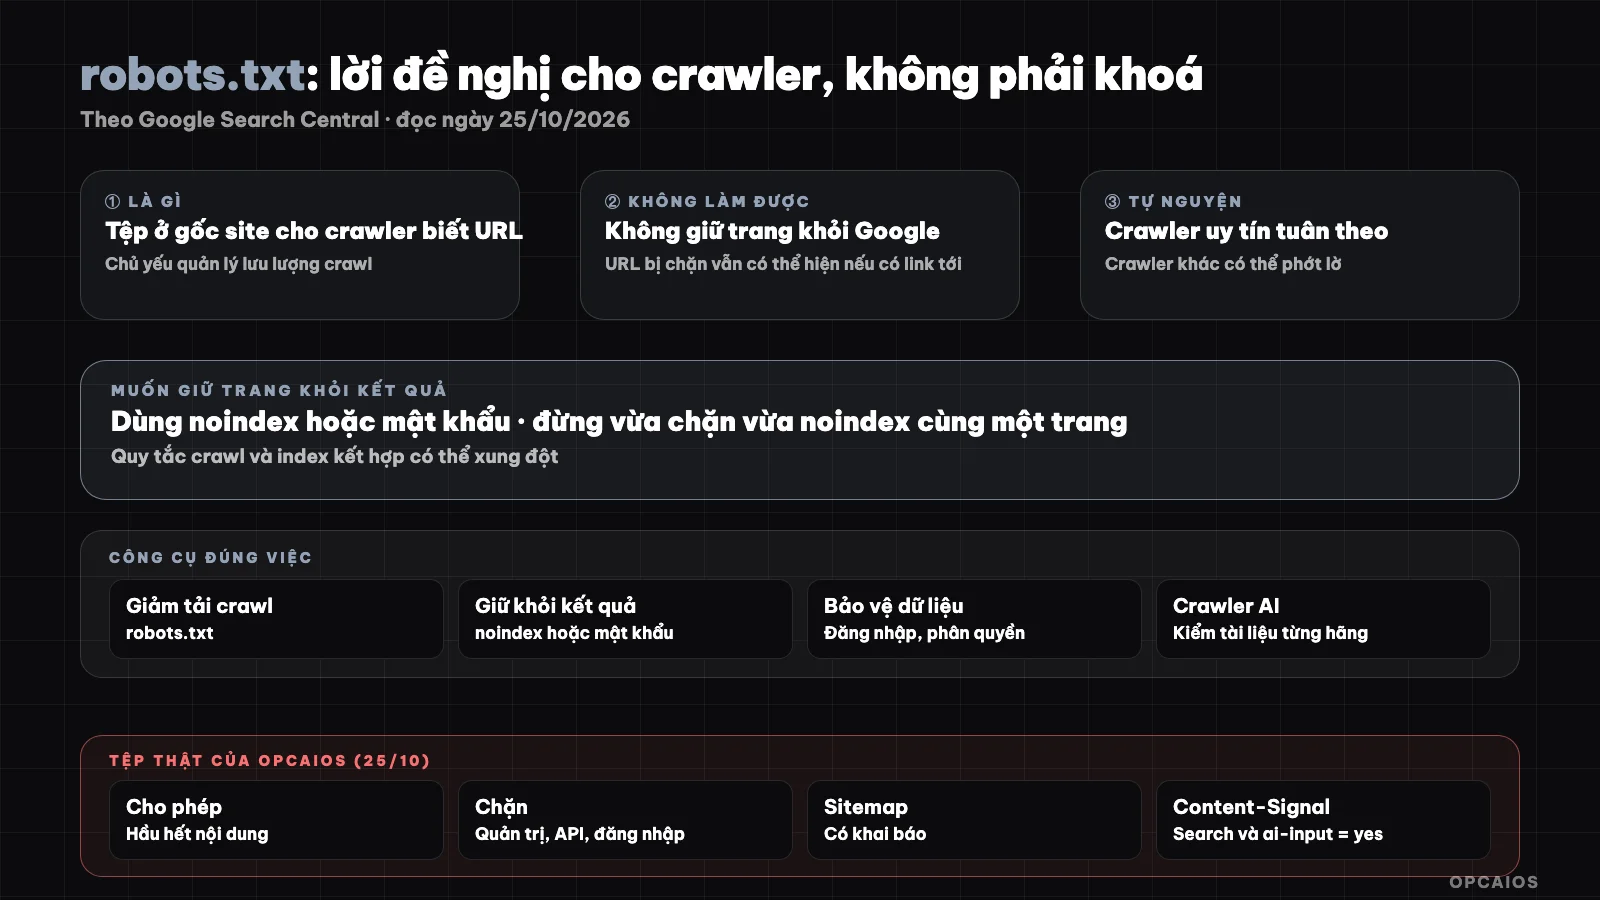
robots.txt là lời đề nghị cho crawler tử tế, không phải ổ khoá. Sơ đồ: OPCAIOS.
robots.txt là gì và dùng để làm gì?
robots.txt cho crawler biết chúng nên và không nên lấy phần nào của site. Mục đích chính theo Google là quản lý lưu lượng crawl, ví dụ không để máy chủ quá tải hay tránh tốn lượt crawl cho trang không quan trọng.
Với tệp phương tiện, robots.txt có thể giúp giữ ảnh, video, âm thanh khỏi kết quả tìm kiếm nhưng không ngăn site khác liên kết tới chúng. Tài liệu cũng khuyên chỉ chặn tệp tài nguyên như script hay CSS khi trang vẫn hoạt động bình thường nếu thiếu chúng. Tôi chưa đọc trang riêng về cú pháp nên các ví dụ bên dưới là minh hoạ chung.
robots.txt không làm được gì?
robots.txt không giữ trang khỏi Google và không bảo mật. Việc tuân thủ là tự nguyện: Googlebot và các crawler uy tín tuân theo, nhưng crawler khác có thể phớt lờ. Muốn giữ trang khỏi kết quả, dùng noindex hoặc bảo vệ bằng mật khẩu.
| Mục tiêu | Công cụ phù hợp |
|---|---|
| Giảm tải crawl, bỏ qua trang không quan trọng | robots.txt |
| Giữ trang khỏi kết quả tìm kiếm | noindex hoặc mật khẩu |
| Bảo vệ dữ liệu riêng tư | Đăng nhập, phân quyền, không phải robots.txt |
| Ẩn tệp nhạy cảm | Đừng để công khai; robots.txt còn làm lộ đường dẫn |
Một lỗi nguy hiểm: chặn trang trong robots.txt rồi thêm noindex vào trang đó, vì crawler không đọc được trang để thấy noindex. Theo tài liệu, kết hợp quy tắc crawl và index có thể gây xung đột.
Cấu trúc cơ bản của tệp
Tệp gồm các nhóm quy tắc: User-agent chỉ crawler nào, Allow và Disallow chỉ đường dẫn, và có thể khai báo Sitemap. Ví dụ minh hoạ:
User-agent: *
Allow: /
Disallow: /admin
Disallow: /api/

Sitemap: https://ten-mien-cua-ban.vn/sitemap.xml
Vị trí, giới hạn kích thước và chi tiết nhóm quy tắc là phần tài liệu trang tôi đọc không bao gồm; hãy xem trang đặc tả của Google trước khi triển khai. Sơ đồ trang giúp crawler tìm nội dung, xem Google Search Console.
Crawler AI và robots.txt
Nhiều hãng AI có crawler riêng cho tìm kiếm, cho truy xuất theo yêu cầu của người dùng và cho huấn luyện. Theo ghi chú nghiên cứu nội bộ của OPCAIOS (đọc ngày 24/10/2026), chặn crawler huấn luyện không nhất thiết chặn trích dẫn trong tìm kiếm AI; việc phân loại và tên crawler thay đổi nhanh nên hãy kiểm tra tài liệu của từng hãng.
Đây là quyết định kinh doanh: cho phép AI đọc giúp nội dung có thể được trích dẫn, nhưng nội dung cũng có thể được dùng theo cách bạn không mong muốn. Xem SEO và GEO là gì và đo AI có trích dẫn website không.
Kinh nghiệm của OPCAIOS
Ngày 25/10/2026, tệp robots.txt công khai của opcaios.org cho phép crawler vào hầu hết nội dung và chặn các đường dẫn quản trị, API, đăng nhập và một đường dẫn WordPress cũ; có khai báo sitemap. Tệp còn có một dòng Content-Signal ghi search=yes, ai-input=yes, tức tín hiệu cho phép dùng nội dung cho tìm kiếm và làm đầu vào cho AI.
Hạn chế: chúng tôi chưa xác minh crawler nào thực sự tôn trọng dòng tín hiệu đó, nên coi nó là khai báo ý định, không phải cơ chế cưỡng chế. Và chúng tôi không dựa vào robots.txt để bảo vệ khu quản trị: nó được bảo vệ bằng đăng nhập. Xem rà soát bảo mật website.
Câu hỏi thường gặp
robots.txt có ngăn trang xuất hiện trên Google không?
Không đảm bảo. Theo Google, URL bị chặn vẫn có thể hiện nếu có liên kết tới; muốn tránh, dùng noindex hoặc mật khẩu.
robots.txt có bảo mật không?
Không. Tuân thủ là tự nguyện, và tệp công khai còn cho người khác thấy bạn muốn tránh đường dẫn nào.
Có nên chặn crawler AI không?
Tuỳ mục tiêu: muốn được AI trích dẫn thì nên cho crawler tìm kiếm vào. Kiểm tra tài liệu từng hãng vì tên và vai trò crawler đổi nhanh.
Chặn CSS và JavaScript trong robots.txt được không?
Google chỉ khuyên chặn tệp tài nguyên khi trang vẫn chạy bình thường nếu thiếu chúng.
Tôi nên bắt đầu từ đâu?
Mở /robots.txt của site, kiểm tra không chặn nhầm trang quan trọng và có khai báo sitemap. Cần hỗ trợ, xem dịch vụ đào tạo ứng dụng AI.
Nguồn: Google Search Central, "Introduction to robots.txt" (developers.google.com), đọc ngày 25/10/2026; chưa đọc phần vị trí tệp, cú pháp nhóm, giới hạn kích thước. robots.txt của opcaios.org do OPCAIOS tải ngày 25/10/2026. Ghi chú về crawler AI lấy từ nghiên cứu nội bộ ngày 24/10/2026. Kinh nghiệm là của OPCAIOS.
Để lại bình luận
Email của bạn sẽ không hiển thị công khai. Bình luận sẽ hiển thị sau khi được duyệt.