


Whisper là gì? Whisper là mô hình nhận dạng giọng nói mã nguồn mở do OpenAI phát hành, dùng để chuyển âm thanh thành văn bản, dịch lời nói sang tiếng Anh và tự nhận diện ngôn ngữ, trong đó có tiếng Việt. Theo API GitHub (đọc ngày 04/11/2026), kho openai/whisper được tạo ngày 16/9/2022, có khoảng 111.900 sao, giấy phép MIT, viết bằng Python và lần đẩy mã gần nhất là ngày 31/8/2026. Theo model card trong kho, mô hình được huấn luyện trên 680.000 giờ âm thanh thu thập từ internet, con số do OpenAI công bố, chưa kiểm chứng. Bài này trả lời: Whisper làm được gì, có mấy cỡ mô hình, cần máy gì, cài thế nào, giới hạn và rủi ro ra sao, và khi nào một người làm một mình nên dùng.
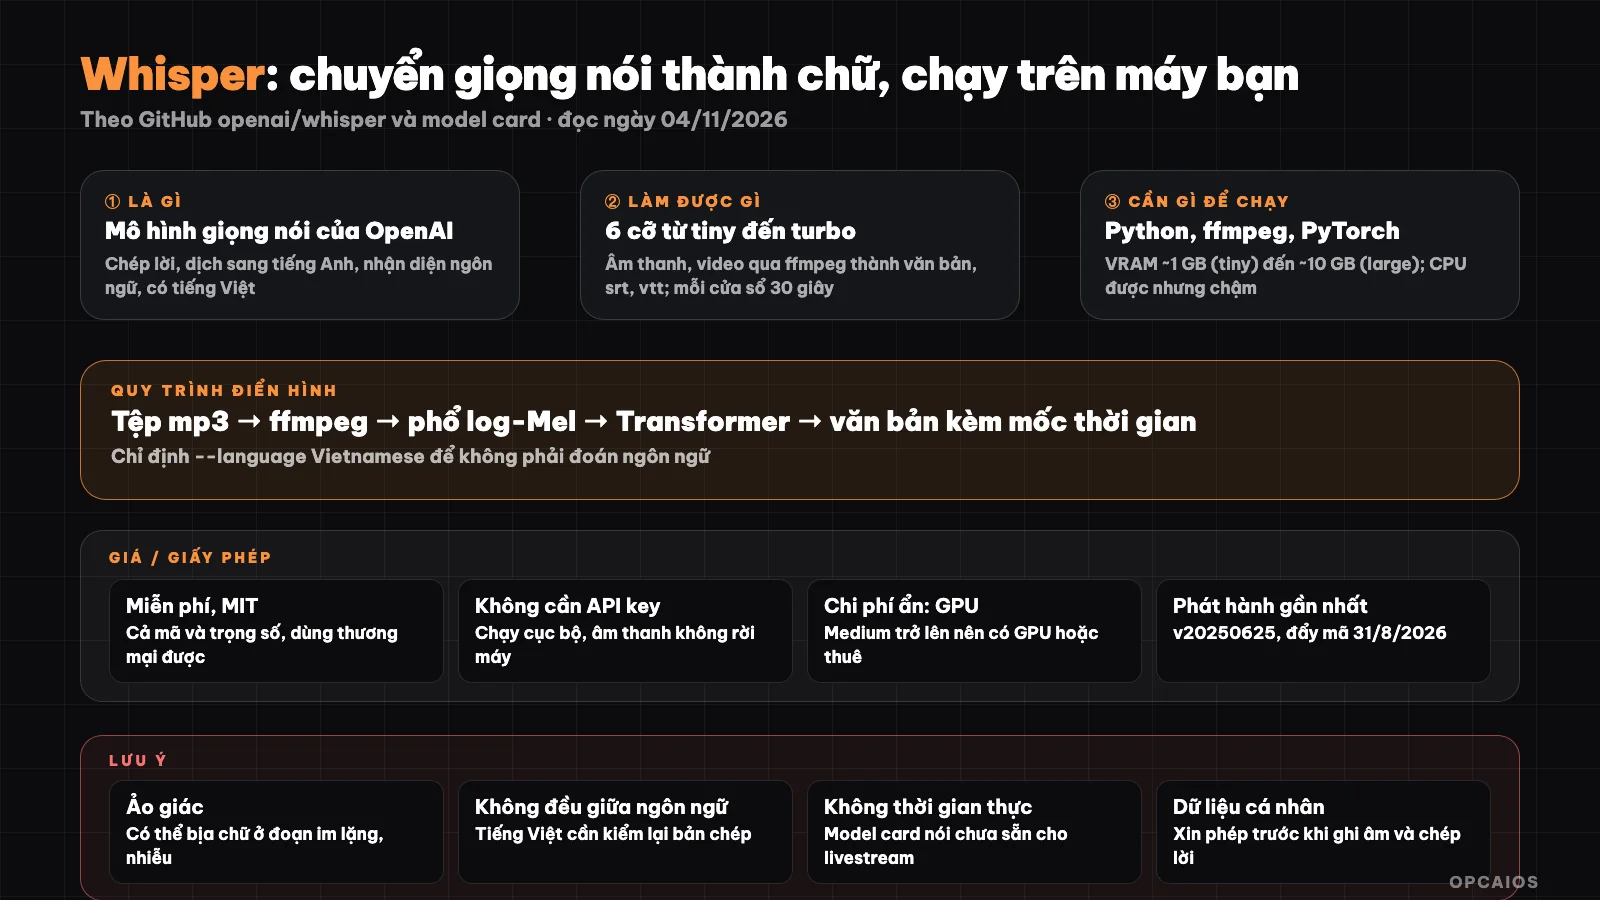
Whisper nhận âm thanh, xử lý từng cửa sổ 30 giây và trả về văn bản. Sơ đồ: OPCAIOS.
Whisper là gì và ai tạo ra?
Whisper là mô hình nhận dạng giọng nói đa nhiệm của OpenAI, phát hành tháng 9/2022 kèm mã nguồn và trọng số theo giấy phép MIT. Một mô hình duy nhất làm cả ba việc: chép lời (transcribe), dịch lời nói sang tiếng Anh và nhận diện ngôn ngữ, thay cho nhiều bước của quy trình xử lý giọng nói truyền thống.
Về kỹ thuật, README của kho mô tả Whisper là mô hình Transformer dạng chuỗi sang chuỗi. Phần mã hoá đọc phổ âm thanh, phần giải mã sinh ra chuỗi token, và các "token đặc biệt" cho mô hình biết đang làm nhiệm vụ gì: chép lời, dịch, hay chỉ xác định ngôn ngữ. Nhờ cách huấn luyện này, Whisper còn học luôn việc phát hiện có tiếng nói hay không trong đoạn âm thanh. Theo model card (đọc ngày 04/11/2026), dữ liệu huấn luyện gồm 680.000 giờ, khoảng 65% là tiếng Anh, phần còn lại trải trên 98 ngôn ngữ khác. OpenAI cũng công bố bài báo "Robust Speech Recognition via Large-Scale Weak Supervision" trên arXiv (mã 2212.04356). Các mốc phát hành theo model card: bản gốc tháng 9/2022, large-v2 tháng 12/2022, large-v3 tháng 11/2023 và turbo tháng 9/2024. Bản phát hành gần nhất trên GitHub có nhãn v20250625 (26/6/2025).
Whisper làm được những gì?
Whisper làm được ba việc chính: chép lời từ tệp âm thanh thành văn bản, dịch lời nói ở ngôn ngữ khác sang tiếng Anh, và nhận diện ngôn ngữ đang nói. Người dùng chọn một trong sáu cỡ mô hình tuỳ máy và độ chính xác cần. Bảng dưới tóm tắt theo README (đọc ngày 04/11/2026).
| Tính năng | Mô tả theo README |
|---|---|
| Chép lời (transcribe) | Đọc cả tệp, xử lý từng cửa sổ 30 giây, trả văn bản kèm mốc thời gian theo đoạn |
| Dịch sang tiếng Anh (translate) | Dùng tuỳ chọn --task translate với mô hình đa ngôn ngữ; bản turbo không hỗ trợ dịch |
| Nhận diện ngôn ngữ | Hàm detect_language trả xác suất cho từng ngôn ngữ |
| Sáu cỡ mô hình | tiny (39M tham số, ~1 GB VRAM), base (74M, ~1 GB), small (244M, ~2 GB), medium (769M, ~5 GB), large (1550M, ~10 GB), turbo (809M, ~6 GB) |
| Bản chỉ tiếng Anh | tiny.en, base.en, small.en, medium.en: chính xác hơn với tiếng Anh ở cỡ nhỏ |
| Dòng lệnh và Python | Lệnh whisper và thư viện import whisper |
| Định dạng đầu vào | Mọi định dạng ffmpeg đọc được: mp3, wav, flac, m4a, kể cả video |
README ghi turbo là bản tối ưu từ large-v3, nhanh hơn khoảng 8 lần so với large với độ chính xác giảm nhẹ; tốc độ đo trên GPU A100 với tiếng Anh, máy của bạn sẽ khác. Với tiếng Việt, chúng tôi chưa tự đo.
Whisper có miễn phí không? Giấy phép và chi phí ẩn
Whisper miễn phí: cả mã nguồn và trọng số mô hình đều theo giấy phép MIT, dùng được cho mục đích thương mại. Chi phí thật nằm ở phần cứng và thời gian: mô hình lớn cần GPU có VRAM đủ, còn chạy bằng CPU thì chậm hơn nhiều. Bảng dưới tóm tắt (đọc ngày 04/11/2026, có thể thay đổi).
| Khoản | Chi tiết |
|---|---|
| Phí phần mềm | 0 đồng, giấy phép MIT cho mã và trọng số |
| GPU | Không bắt buộc nhưng gần như cần cho bản medium trở lên; VRAM từ ~1 GB (tiny) đến ~10 GB (large) theo README |
| Máy chủ thuê | Nếu không có GPU, thuê máy chủ GPU theo giờ; giá do nhà cung cấp quyết định, chúng tôi không nêu vì chưa đọc bảng giá chính thức nào trong bài này |
| API key | Không cần: Whisper chạy hoàn toàn cục bộ, không gọi về OpenAI |
| Dung lượng tải | Trọng số mô hình tải về lần đầu, bản large cỡ vài GB |
| Phần mềm phụ | ffmpeg (miễn phí), Python 3.8 đến 3.11, PyTorch; có thể cần Rust nếu thiếu bản dựng sẵn của tiktoken |
OpenAI cũng bán dịch vụ chép lời qua API; chúng tôi không đọc trang giá nên không nêu.
Cài Whisper và chạy thử thế nào?
Cài Whisper cần Python, ffmpeg và một lệnh pip. Theo README (đọc ngày 04/11/2026), quy trình gồm bốn bước.
- Đầu tiên, cài ffmpeg vì Whisper dùng nó để đọc tệp âm thanh. Trên macOS:
brew install ffmpeg
Trên Ubuntu hoặc Debian: sudo apt update && sudo apt install ffmpeg. Trên Windows có thể dùng Chocolatey (choco install ffmpeg) hoặc Scoop.
- Tiếp theo, cài gói Python từ PyPI:
pip install -U openai-whisper
README nêu mã được kỳ vọng chạy với Python 3.8 đến 3.11 và PyTorch bản gần đây. Nếu pip báo lỗi liên quan tiktoken, cài Rust theo hướng dẫn chính thức rồi thêm ~/.cargo/bin vào PATH; thiếu setuptools_rust thì chạy pip install setuptools-rust.
- Sau đó, chép lời tệp đầu tiên bằng dòng lệnh. Mô hình mặc định là
turbo:
whisper audio.mp3 --model turbo
Với giọng Việt, nên chỉ định ngôn ngữ để mô hình không phải đoán: thêm --language Vietnamese. Muốn dịch sang tiếng Anh, dùng mô hình đa ngôn ngữ như medium hoặc large kèm --task translate; turbo sẽ trả về nguyên ngôn ngữ gốc vì không được huấn luyện để dịch.
- Cuối cùng, nếu cần gọi từ mã Python, README cho ví dụ ba dòng:
whisper.load_model("turbo"),model.transcribe("audio.mp3")rồi đọcresult["text"]. Lần chạy đầu sẽ tải trọng số mô hình về máy.
Ví dụ (ví dụ giả định): một người làm podcast một mình thu 40 phút mỗi tuần, chạy whisper ep12.m4a --model small --language Vietnamese trên laptop không có GPU rời, đợi vài chục phút, rồi dùng bản chép để viết mô tả tập và bài blog. Thời gian thực tế phụ thuộc máy, chúng tôi chưa đo.
Giới hạn, rủi ro và lưu ý pháp lý khi dùng Whisper
Whisper có ba giới hạn chính theo chính model card của OpenAI: có thể "ảo giác" ra chữ không có trong âm thanh, độ chính xác không đều giữa các ngôn ngữ, và không phù hợp cho chép lời thời gian thực ngay từ hộp. Người dùng cần kiểm tra lại bản chép trước khi đăng hoặc dùng làm bằng chứng.
Cụ thể hơn, model card (đọc ngày 04/11/2026) nêu: văn bản đầu ra có thể chứa câu mô hình tự bịa, nhất là ở đoạn im lặng hoặc nhiễu; tỷ lệ lỗi cao hơn với ngôn ngữ ít dữ liệu huấn luyện; lỗi có thể khác nhau theo giọng vùng miền, giới tính, tuổi; và mô hình đôi khi lặp lại một cụm từ nhiều lần, điều mà beam search và điều chỉnh nhiệt độ chỉ giảm được một phần. OpenAI cũng ghi rõ những cách dùng ngoài phạm vi: chép lời bản ghi âm người khác khi chưa có sự đồng ý của họ, suy đoán đặc điểm con người từ giọng nói, và dùng cho quyết định rủi ro cao khi lỗi có thể gây hại nghiêm trọng.
Về dữ liệu cá nhân: điểm cộng là Whisper chạy cục bộ, âm thanh không rời máy bạn, khác với các dịch vụ chép lời trên đám mây. Nhưng bản ghi cuộc họp, cuộc gọi khách hàng vẫn là dữ liệu cá nhân của người khác. Hãy xin phép trước khi ghi âm và chép lời, lưu tệp có kiểm soát, và xoá khi không còn cần. Phần này là tham khảo, không phải tư vấn pháp lý, và chúng tôi chưa đối chiếu với văn bản luật cụ thể của Việt Nam hay GDPR.
Dự án ít phát hành bản mới (bản gần nhất 6/2025 theo GitHub), nên đừng kỳ vọng tính năng mới nhanh.
Whisper so với các lựa chọn khác
Whisper gốc là mô hình tham chiếu; nhiều công cụ phổ biến thực ra chạy chính trọng số Whisper nhưng được tối ưu lại. Bảng dưới là mô tả chung, không phải đo đạc của chúng tôi.
| Lựa chọn | Khác gì Whisper gốc | Hợp với ai |
|---|---|---|
| Whisper gốc (openai/whisper) | Mã tham chiếu bằng PyTorch, dễ hiểu, dễ sửa | Người muốn thử nhanh, lập trình Python |
| faster-whisper, whisper.cpp | Cùng trọng số, chạy nhanh hơn hoặc chạy trên CPU và máy Mac | Người cần tốc độ hoặc không có GPU NVIDIA |
| API chép lời của OpenAI | Trả tiền theo phút, không cần máy mạnh, âm thanh gửi lên máy chủ | Người cần đơn giản, chấp nhận gửi dữ liệu |
| Dịch vụ chép lời thương mại (có giao diện) | Có chỉnh sửa, tách người nói, cộng tác | Người không biết code |
| Mô hình giọng nói khác (mã nguồn mở) | Khác kiến trúc, chất lượng tiếng Việt cần tự thử | Người muốn so sánh |
Trong cùng đợt bài này, chúng tôi cũng viết về Voice Pro và AI Video Transcriber, hai công cụ có giao diện dựng trên các mô hình chép lời.
Khi nào nên dùng Whisper?
Nên dùng Whisper khi bạn cần chép lời tiếng Việt hoặc tiếng Anh với số lượng lớn, muốn dữ liệu ở lại máy, và chấp nhận chỉnh tay một phần. Không nên dùng khi cần chữ chạy thời gian thực hoặc không có ai kiểm lại bản chép.
| Tình huống | Gợi ý |
|---|---|
| Chép lời podcast, video YouTube của chính mình để viết bài | Dùng Whisper cỡ small hoặc medium, chỉ định --language Vietnamese |
| Ghi chú cuộc họp nội bộ, muốn giữ dữ liệu trong máy | Dùng Whisper, xin phép người tham gia trước |
| Phụ đề thời gian thực cho livestream | Không hợp; model card nói Whisper không sẵn sàng cho thời gian thực |
| Chép hàng trăm giờ, không có GPU | Cân nhắc faster-whisper, whisper.cpp hoặc thuê máy chủ GPU |
| Không biết code, cần giao diện | Dùng ứng dụng dựng trên Whisper hoặc dịch vụ thương mại |
| Bản chép làm bằng chứng pháp lý, y tế | Không hợp; model card xếp vào dùng ngoài phạm vi |
Kinh nghiệm của OPCAIOS
Chúng tôi mới đưa Whisper vào danh mục Repo của mục Tiện ích trên opcaios.org sau khi đọc README và kiểm tra kho còn cập nhật; chúng tôi chưa chạy thử, nên phần này nêu tiêu chí chúng tôi dùng để cân nhắc, không phải đánh giá sau khi dùng.
Tiêu chí thứ nhất là kho còn được cập nhật không: lần đẩy mã gần nhất là 31/8/2026 theo API GitHub, bản phát hành gần nhất tháng 6/2025, tức dự án ở trạng thái bảo trì chứ không phát triển mạnh; với một mô hình đã ổn định, điều này chấp nhận được. Tiêu chí thứ hai là giấy phép: MIT cho cả mã và trọng số, phù hợp để đưa vào quy trình nội bộ hay sản phẩm. Tiêu chí thứ ba là chi phí ẩn: không có phí phần mềm hay API key, nhưng cần GPU hoặc thời gian chờ; chúng tôi có dùng một máy chủ GPU thuê cho quy trình dựng video người nói với OmniVoice, nên Whisper có thể chạy chung trên đó khi cần chép lời. Tiêu chí thứ tư là có thay được công cụ đang dùng không: hiện chúng tôi chép lời bằng các dịch vụ có sẵn trong công cụ AI; Whisper hấp dẫn ở chỗ giữ âm thanh trong máy. Cuối cùng là rủi ro: không có vấn đề điều khoản nền tảng, chỉ có rủi ro ảo giác và dữ liệu cá nhân như đã nêu.
Đọc thêm: Ollama là gì? để chạy mô hình ngôn ngữ cục bộ cùng máy, Biến video YouTube thành 10 bài viết, n8n là gì? để tự động hoá bước chép lời, 6 công cụ chuyển giọng nói thành văn bản tốt nhất 2026.
Câu hỏi thường gặp
Whisper có hỗ trợ tiếng Việt không?
Có. Whisper là mô hình đa ngôn ngữ, tiếng Việt nằm trong danh sách ngôn ngữ ở tệp tokenizer.py của kho, và model card công bố tỷ lệ lỗi theo từng ngôn ngữ trên bộ Common Voice 15 và Fleurs. Tuy nhiên OpenAI nói rõ độ chính xác không đều giữa các ngôn ngữ và thấp hơn với ngôn ngữ ít dữ liệu. Với giọng Việt vùng miền, thuật ngữ chuyên ngành hay nhiễu nền, bạn nên dùng cỡ medium trở lên, chỉ định --language Vietnamese và đọc lại bản chép. Chúng tôi chưa đo chất lượng tiếng Việt bằng số.
Whisper có cần GPU không?
Không bắt buộc, nhưng rất nên có nếu dùng cỡ medium, large hoặc turbo. README nêu VRAM cần khoảng 1 GB cho tiny và base, 2 GB cho small, 5 GB cho medium, 6 GB cho turbo và 10 GB cho large. Chạy bằng CPU vẫn được với cỡ nhỏ, chỉ chậm hơn nhiều. Nếu máy không có GPU NVIDIA, bạn có thể thuê máy chủ GPU theo giờ, hoặc dùng các bản tối ưu như whisper.cpp chạy tốt hơn trên CPU và máy Mac. Thời gian xử lý thực tế phụ thuộc máy và ngôn ngữ, README chỉ cho con số tương đối đo trên A100.
Whisper có gửi âm thanh của tôi lên OpenAI không?
Không. Kho openai/whisper chạy hoàn toàn trên máy bạn: trọng số mô hình tải về một lần, sau đó mọi phép tính diễn ra cục bộ, không cần API key và không gọi về máy chủ OpenAI. Đây là khác biệt chính so với API chép lời trả phí của OpenAI, nơi tệp âm thanh được gửi lên đám mây. Nếu bạn dùng Whisper qua một ứng dụng bên thứ ba, hãy kiểm tra ứng dụng đó có gửi dữ liệu đi đâu không, vì chính sách của họ không nằm trong phạm vi giấy phép MIT của Whisper.
Whisper khác gì faster-whisper và whisper.cpp?
Whisper gốc là mã tham chiếu bằng PyTorch do OpenAI phát hành. faster-whisper và whisper.cpp là dự án của cộng đồng, dùng cùng trọng số nhưng viết lại phần chạy mô hình để nhanh hơn, tốn ít bộ nhớ hơn hoặc chạy được trên CPU, Apple Silicon. Về chất lượng chép lời, chúng cùng gốc nên tương đương về nguyên tắc, nhưng cách chia đoạn và tham số mặc định có thể khác. Đây là mô tả chung, không phải đo đạc của chúng tôi; nếu cần tốc độ, hãy thử cả hai trên chính tệp của bạn.
Người không biết code có dùng Whisper được không?
Dùng được ở mức dòng lệnh: sau khi cài ffmpeg và chạy pip install -U openai-whisper, bạn chỉ cần một lệnh whisper tep.mp3 --language Vietnamese để có bản chép dạng txt, srt, vtt. Nếu dòng lệnh vẫn là rào cản, hãy chọn ứng dụng có giao diện dựng trên Whisper, hoặc nhờ một tác tử AI như Claude Code cài và chạy giúp rồi kiểm tra kết quả. Cách tiếp cận này, dùng AI để vận hành công cụ kỹ thuật mà không cần tự viết mã, là nội dung chúng tôi hướng dẫn trong khoá đào tạo ứng dụng AI của OPCAIOS.
Nguồn: GitHub openai/whisper (README, model-card.md, API, trang phát hành, đọc ngày 04/11/2026); chưa đọc/chưa kiểm chứng: bài blog giới thiệu Whisper trên openai.com (trang trả lỗi 403 khi đọc), trang giá API chép lời của OpenAI, bài báo arXiv 2212.04356; số sao và giá có thể thay đổi. Kinh nghiệm là của OPCAIOS.
Để lại bình luận
Email của bạn sẽ không hiển thị công khai. Bình luận sẽ hiển thị sau khi được duyệt.