


Ollama là gì? Ollama là công cụ mã nguồn mở để tải và chạy các mô hình ngôn ngữ mở (như Gemma, Qwen, Llama, DeepSeek, Mistral) ngay trên máy tính hoặc máy chủ của bạn, kèm API cục bộ để ứng dụng khác gọi vào. Theo kho GitHub (đọc ngày 25/10/2026), Ollama giấy phép MIT, khoảng 184,7 nghìn sao, chạy trên macOS, Linux, Windows và Docker, xây trên dự án llama.cpp. Dữ liệu khi chạy cục bộ không rời máy bạn; Ollama cũng có mô hình đám mây tính phí. Ví dụ giả định: chạy một mô hình 7B trên máy 16 GB RAM trong 1 giờ mỗi ngày không tốn phí token, còn gói đám mây Pro tốn $20 mỗi tháng. Bài giải thích Ollama là gì, cách cài và dùng, API, yêu cầu phần cứng, gói đám mây và giá, rủi ro bảo mật khi mở cổng ra mạng, so sánh với dùng API đám mây, và kinh nghiệm thật của OPCAIOS (chúng tôi chạy Ollama trên máy chủ).
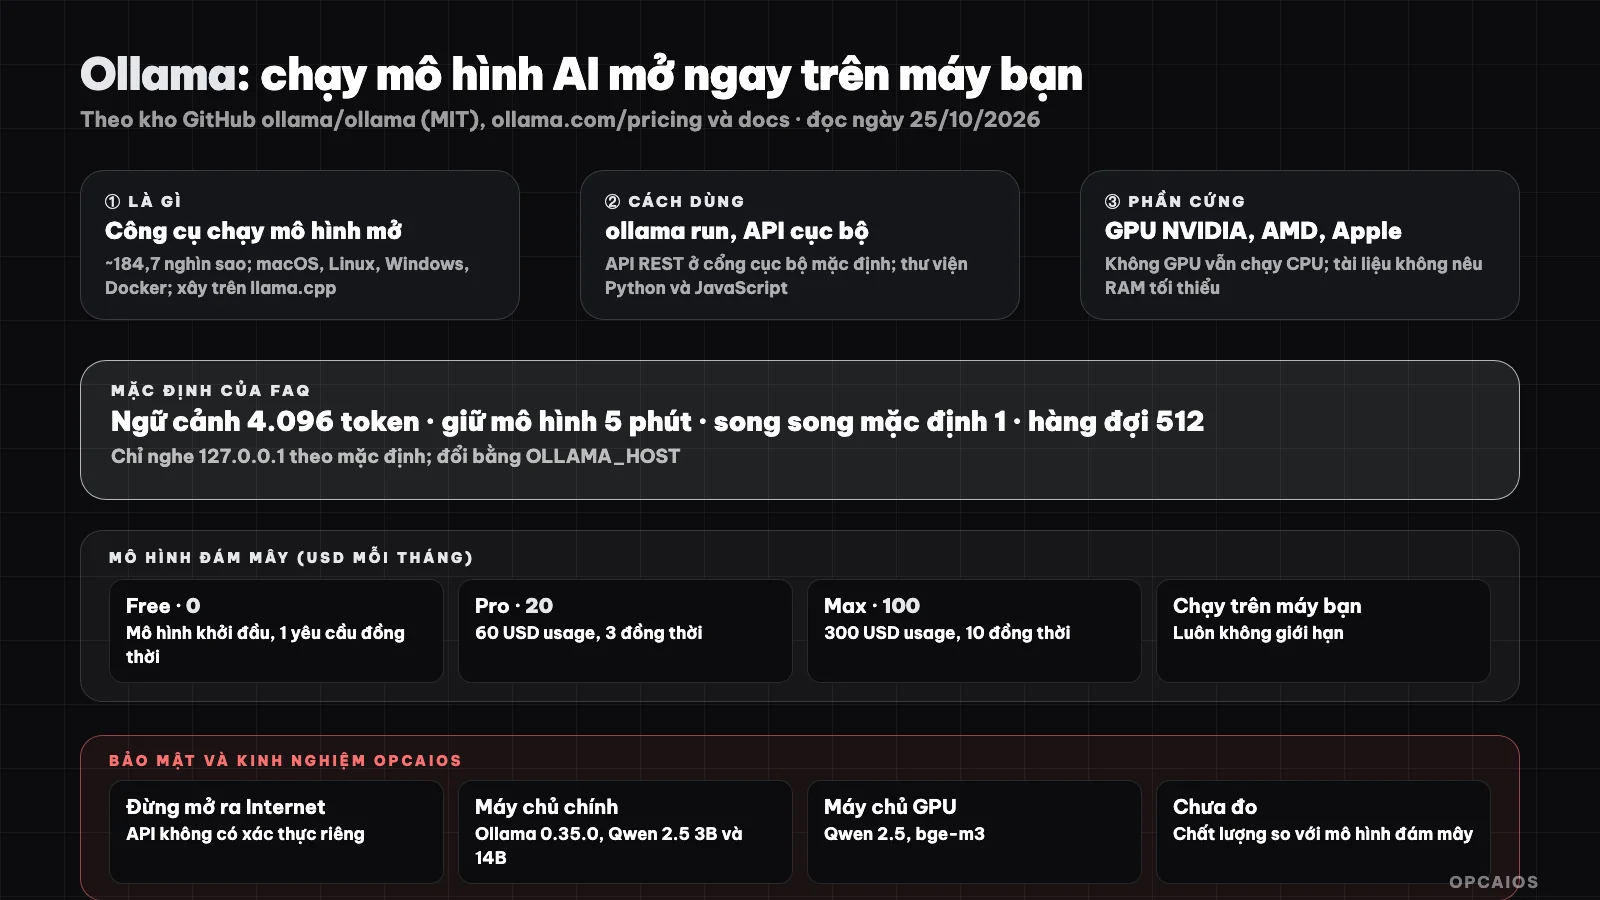
Mô hình chạy trên máy bạn, dữ liệu ở lại máy; chất lượng phụ thuộc mô hình và phần cứng. Sơ đồ: OPCAIOS.
Ollama là gì và dùng để làm gì?
Ollama là công cụ chạy mô hình mở cục bộ hoặc trên đám mây, với quyền riêng tư đầy đủ khi chạy trên máy bạn (theo trang kho mã GitHub, đọc ngày 25/10/2026). Bốn việc thường làm:
- Trò chuyện với mô hình mở như Gemma, Qwen hay Llama.
- Nhúng văn bản cho tìm kiếm ngữ nghĩa (xem RAG là gì?).
- Chạy tác tử lập trình hoặc trợ lý không cần gửi dữ liệu ra ngoài.
- Thử nhanh các mô hình mới.
Trang nêu các tích hợp: Claude Code, Codex, Copilot CLI, OpenCode và OpenClaw, qua lệnh ollama launch. Mô hình mẫu trong tài liệu là Gemma 4; thẻ chủ đề nhắc Kimi, GLM, MiniMax, DeepSeek, gpt-oss, Qwen, Llama, Mistral. Về khái niệm mô hình ngôn ngữ, xem LLM là gì?. Ví dụ giả định: một văn phòng 3 người nhúng 10.000 trang tài liệu nội bộ bằng Ollama trong 2 ngày, giữ 100% dữ liệu trên máy và không trả phí token cho Google hay OpenAI.
Cài đặt và cách dùng
- Cài: macOS và Linux bằng một dòng lệnh shell (hoặc tệp DMG trên macOS); Windows bằng PowerShell hoặc trình cài đặt; Docker với ảnh
ollama/ollama(xem Docker là gì?). - Chạy mô hình:
ollama run <tên mô hình>(ví dụollama run gemma4) để tải và trò chuyện; thư viện mô hình ở ollama.com/library. - Gọi từ ứng dụng: API REST phục vụ cục bộ ở cổng 11434, ví dụ gọi điểm cuối
/api/chatvới tên mô hình và danh sách tin nhắn; có thư viện chính thức cho Python (pip install ollama) và JavaScript (npm i ollama). - Tuỳ chỉnh: tệp Modelfile để đặt tham số và lời nhắc hệ thống (tài liệu có phần tham chiếu riêng).
Ví dụ giả định: một mô hình 4 GB tải mất khoảng 15 phút, và 2 người dùng cùng lúc làm tăng bộ nhớ cần cho ngữ cảnh khoảng 100% so với 1 người dùng. Theo FAQ: mô hình lưu ở ~/.ollama/models trên macOS (đổi bằng OLLAMA_MODELS); độ dài ngữ cảnh mặc định 4.096 token (đổi bằng OLLAMA_CONTEXT_LENGTH); mô hình ở lại bộ nhớ 5 phút theo mặc định (keep_alive); OLLAMA_NUM_PARALLEL mặc định 1 và hàng đợi tối đa mặc định 512; yêu cầu song song làm tăng bộ nhớ cần cho ngữ cảnh.
Yêu cầu phần cứng
Theo tài liệu GPU của Ollama: NVIDIA cần compute capability 5.0 trở lên và trình điều khiển 550 trở lên (thẻ 5.0 đến 6.2 cần 570 trở lên); AMD trên Linux cần ROCm v7; Apple dùng GPU qua Metal; có thêm Vulkan trên Windows và Linux. Nếu không có GPU phù hợp, Ollama chạy bằng CPU (chậm hơn). Tài liệu không nêu mức RAM tối thiểu, nên chúng tôi không đưa ra con số chung: dung lượng cần thiết phụ thuộc kích thước mô hình, lượng tử hoá và độ dài ngữ cảnh; hãy xem kích thước tệp mô hình trong thư viện và để dư bộ nhớ.
Ollama có gói đám mây và giá bao nhiêu?
Ollama miễn phí khi chạy trên phần cứng của bạn, còn mô hình đám mây tính theo token với ba gói. Theo trang giá chính thức (đọc ngày 25/10/2026, chưa gồm thuế):
- Free $0: một lượng nhỏ cho mô hình khởi đầu, 1 yêu cầu đồng thời.
- Pro $20 mỗi tháng (hoặc $200 mỗi năm): kèm $60 usage mỗi tháng và 3 yêu cầu đồng thời.
- Max $100 mỗi tháng: kèm $300 usage và 10 yêu cầu đồng thời.
Ví dụ giá: mô hình gpt-oss:20b $0,07 mỗi triệu token đầu vào và $0,30 mỗi triệu token đầu ra. Ví dụ tính toán: 10 triệu token đầu vào cộng 2 triệu token đầu ra là $0,70 + $0,60 = $1,30, khoảng 2% usage $60 của gói Pro. Usage đặt lại hằng tháng và không chuyển sang tháng sau. Theo FAQ, với mô hình đám mây, prompt và phản hồi được xử lý để cung cấp dịch vụ nhưng không lưu, không ghi nhật ký và không dùng để huấn luyện (tuyên bố của Ollama, chưa kiểm chứng); có thể tắt tính năng đám mây bằng OLLAMA_NO_CLOUD=1.
Bảo mật khi dùng Ollama cần chú ý gì?
Bảo mật Ollama là giữ cho API cục bộ không bị truy cập từ ngoài. Ví dụ giả định: một máy chủ mở cổng 11434 ra Internet trong 24 giờ có thể bị người lạ gọi vào và chiếm 100% GPU của bạn. Bốn điểm cần nhớ, theo thứ tự ưu tiên:
- Mặc định chỉ nghe cục bộ: theo FAQ, Ollama gắn vào 127.0.0.1 cổng 11434. Đổi bằng
OLLAMA_HOSTđể mở cho máy khác. - Đừng mở ra Internet: API Ollama không có xác thực riêng; mở công khai nghĩa là ai cũng dùng được máy của bạn. Nếu cần truy cập từ xa, đặt sau proxy có xác thực hoặc đường hầm SSH, hoặc VPN (xem Nginx là gì? và VPS là gì?). Đây là khuyến nghị của chúng tôi dựa trên nguyên tắc chung; FAQ chính thức không đưa cảnh báo này.
- Tải mô hình từ nguồn tin cậy và đọc giấy phép từng mô hình khi dùng thương mại.
- Tài nguyên: chạy mô hình lớn chiếm hết RAM hoặc GPU và có thể làm chậm dịch vụ khác trên cùng máy.
Khi nào nên dùng Ollama?
| Tình huống | Gợi ý |
|---|---|
| Dữ liệu nhạy cảm, không muốn gửi ra ngoài | Ollama cục bộ |
| Tác vụ đơn giản, khối lượng lớn (nhúng văn bản, phân loại) | Phù hợp, tiết kiệm phí token |
| Cần chất lượng suy luận và viết tốt nhất | Mô hình hàng đầu qua API; mô hình mở nhỏ thường kém hơn |
| Máy yếu, không GPU | Cân nhắc API đám mây hoặc mô hình đám mây của Ollama |
| Muốn nhiều mô hình qua một địa chỉ có dự phòng | Thêm cổng như 9Router hoặc OpenRouter |
Kinh nghiệm của OPCAIOS
Chúng tôi chạy Ollama thật: theo kiểm tra ngày 25/10/2026, máy chủ chính đang chạy dịch vụ Ollama bản 0.35.0 (đã chạy liên tục hơn hai tuần) với hai mô hình Qwen 2.5 cỡ 3B và 14B; máy chủ có GPU có Qwen 2.5 (7B và 14B) và mô hình nhúng bge-m3. Trên máy chủ chính, dịch vụ chỉ nghe địa chỉ cục bộ (kiểm tra ngày 25/10/2026); với máy chủ GPU chúng tôi không xác nhận được cách nghe cổng trong lần kiểm tra này. Chúng tôi không ghi lại trong bài mục đích dùng cụ thể của từng mô hình. Chúng tôi chưa đo chất lượng hay tốc độ của các mô hình cục bộ so với mô hình đám mây nên không công bố số liệu, và chưa dùng gói đám mây của Ollama.
Đọc thêm: Hướng dẫn cài đặt Ollama và Open WebUI trên máy tính cá nhân để dùng AI miễn phí 100%, 5 công cụ chạy AI cục bộ tốt nhất 2026.
Câu hỏi thường gặp
Ollama là gì?
Là công cụ mã nguồn mở để tải và chạy mô hình AI mở trên máy của bạn, có API cục bộ.
Ollama có miễn phí không?
Chạy trên máy bạn là miễn phí không giới hạn (giấy phép MIT). Mô hình đám mây có Free $0, Pro $20, Max $100 mỗi tháng.
Cần cấu hình thế nào để chạy Ollama?
Tuỳ mô hình; GPU NVIDIA, AMD, Apple Silicon giúp nhanh hơn, không GPU vẫn chạy bằng CPU. Tài liệu không nêu RAM tối thiểu.
Ollama có an toàn không?
Mặc định chỉ nghe cục bộ nên an toàn; đừng mở cổng ra Internet khi chưa có xác thực.
Ollama thay được ChatGPT hay Claude không?
Không hoàn toàn: mô hình mở chạy cục bộ thường nhỏ hơn và kém hơn trên việc khó; hợp việc riêng tư hoặc việc đơn giản. Muốn học cách chọn mô hình phù hợp, xem khoá đào tạo ứng dụng AI của OPCAIOS.
Nguồn: kho GitHub ollama/ollama, ollama.com/pricing, docs.ollama.com (GPU và FAQ), đọc ngày 25/10/2026; số sao và giá thay đổi nhanh; tài liệu không nêu RAM tối thiểu; cảnh báo xác thực là khuyến nghị của OPCAIOS. Giá chưa gồm thuế. Kinh nghiệm là của OPCAIOS theo kiểm tra trực tiếp.
Để lại bình luận
Email của bạn sẽ không hiển thị công khai. Bình luận sẽ hiển thị sau khi được duyệt.