


Bảo mật khi dùng AI viết code là gì? Bảo mật khi dùng AI viết code là tập thói quen và cấu hình để tác tử lập trình như Claude Code, Codex CLI hay Cursor không bị điều khiển bởi nội dung xấu, không làm lộ khoá bí mật và không làm nhiều hơn mức bạn cho phép. Hai rủi ro lớn nhất là prompt injection (câu lệnh cài cắm trong dữ liệu khiến AI làm theo ý kẻ khác) và lộ khoá bí mật (khoá API, mật khẩu, token nằm trong kho mã, file .env, nhật ký hoặc bị dán vào khung chat). Bài này không hứa có cấu hình nào chống được mọi tấn công; chính tài liệu bảo mật của Claude Code ghi rằng không hệ thống nào miễn nhiễm hoàn toàn. Bài trình bày prompt injection theo OWASP, các đường lộ khoá, quyền quá rộng, gói phụ thuộc lạ, cách phòng và một checklist đánh số.
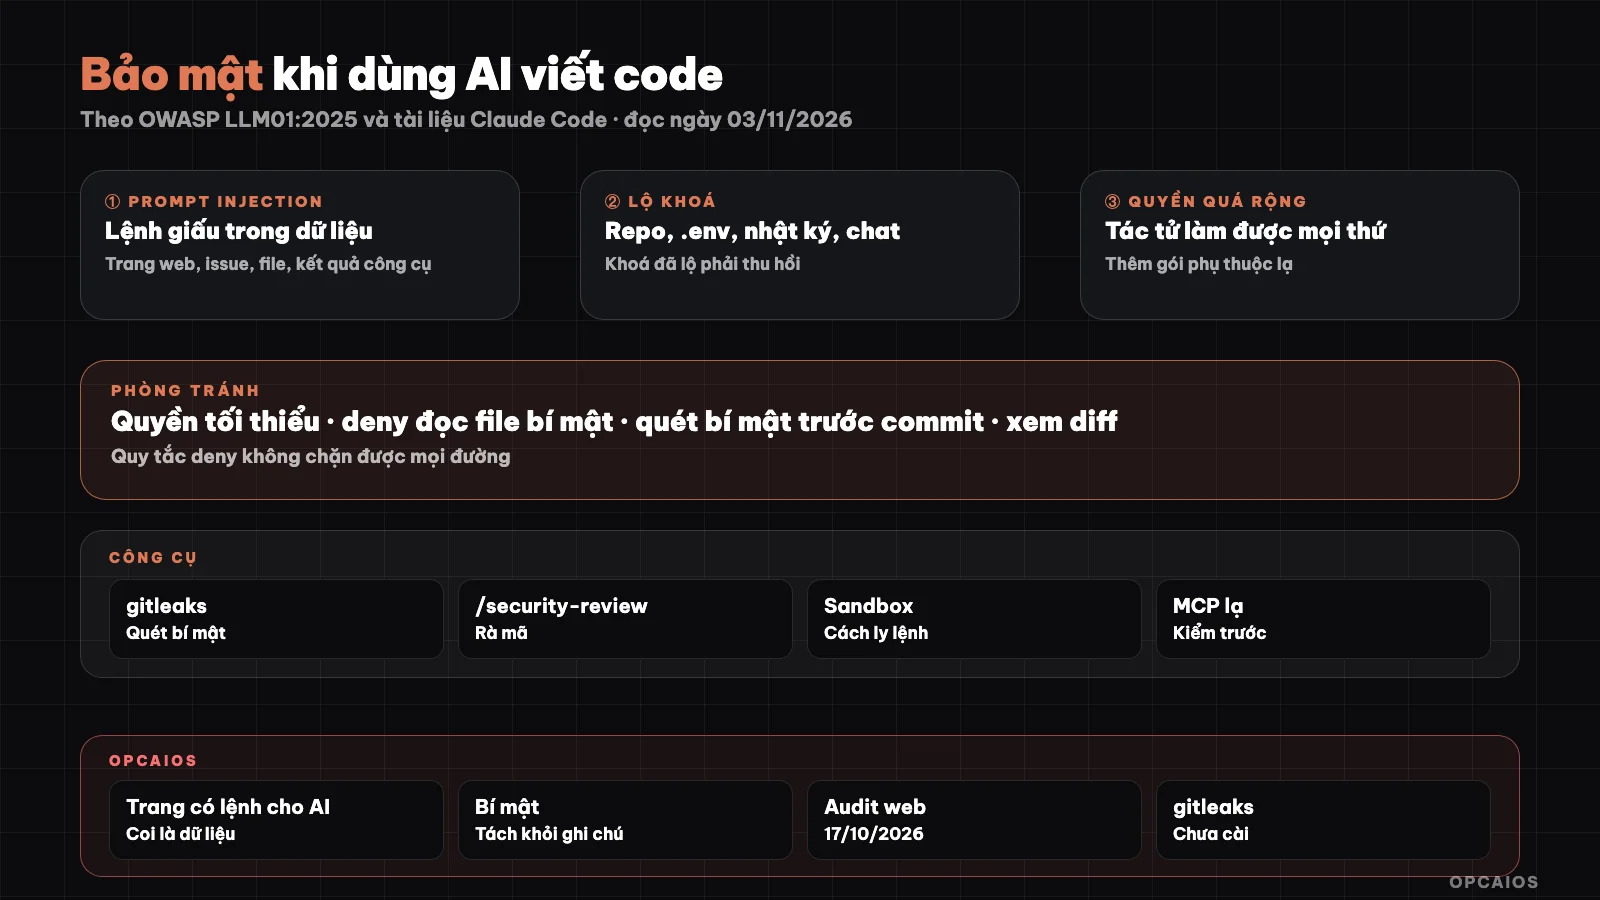
Dữ liệu bên ngoài là dữ liệu, không phải mệnh lệnh; mỗi lớp phòng chặn một đường rò. Sơ đồ: OPCAIOS.
Bài này bổ sung cho 5 quy tắc bảo mật dữ liệu kinh doanh khi dùng AI, tập trung riêng vào việc dùng AI để viết và chạy mã.
Prompt injection là gì?
Prompt injection là lỗ hổng xảy ra khi lời nhắc hoặc nội dung đưa vào mô hình làm thay đổi hành vi hay đầu ra của mô hình theo cách ngoài ý muốn. OWASP xếp lỗ hổng này ở vị trí LLM01 trong danh sách OWASP Top 10 for LLM Applications 2025 (trang genai.owasp.org, đọc ngày 03/11/2026). OWASP chia thành hai loại. Loại trực tiếp là khi chính người dùng gõ lời nhắc làm lệch hành vi, cố ý hoặc vô tình. Loại gián tiếp là khi mô hình đọc nội dung bên ngoài như trang web hay file, và trong đó có chỉ dẫn làm mô hình hành xử khác đi. OWASP còn lưu ý nội dung cài cắm không cần người nhìn thấy, chỉ cần mô hình đọc được, ví dụ chữ trắng trên nền trắng hay chú thích ẩn trong mã. Với tác tử lập trình, loại gián tiếp nguy hiểm hơn hẳn, vì tác tử có quyền chạy lệnh, sửa file và gọi mạng: một câu lệnh cài cắm có thể biến thành hành động thật trên máy bạn, chứ không chỉ là một câu trả lời sai.
Prompt injection gián tiếp đến từ đâu?
Prompt injection gián tiếp đến từ bất kỳ nội dung nào tác tử đọc mà bạn không tự viết. Các nguồn thường gặp khi viết code gồm:
- Trang web và tài liệu trực tuyến: tác tử tìm cách dùng một thư viện, đọc trang tài liệu, và trang đó chứa đoạn văn bảo AI gọi một địa chỉ khác hay chạy một lệnh.
- Issue, bình luận, pull request: người lạ viết nội dung vào kho công khai; nếu một quy trình tự động cho AI đọc rồi hành động, nội dung đó thành mệnh lệnh.
- File trong kho không do mình viết: README, chú thích mã, file cấu hình của dự án tải về.
- Kết quả công cụ: đầu ra của MCP server, kết quả tìm kiếm, nội dung email hay tài liệu mà connector mang vào.
Quy tắc chung: mọi thứ tác tử đọc được từ bên ngoài là dữ liệu, không phải chỉ thị. Khi thấy một đoạn văn nhắm vào AI, hãy dừng lại và báo cho người dùng, không làm theo.
Khoá bí mật bị lộ qua những đường nào?
Khoá bí mật bị lộ chủ yếu qua 4 đường, và tác tử AI làm cả 4 đường dễ xảy ra hơn vì nó đọc và viết rất nhiều file:
- Khoá viết thẳng vào mã rồi commit: tác tử "cho chạy được" bằng cách dán khoá vào file cấu hình, và commit lên kho. Lịch sử Git giữ khoá cả khi bạn xoá ở commit sau.
- File
.envbị đọc hoặc bị đưa lên Git: tác tử đọc.envđể hiểu cấu hình, nội dung đó đi vào ngữ cảnh gửi tới dịch vụ AI; hoặc.gitignorethiếu dòng.env. - Nhật ký và đầu ra lệnh: lệnh in biến môi trường, nhật ký lỗi chứa chuỗi kết nối cơ sở dữ liệu, kết quả được lưu hay dán lại.
- Dán khoá vào khung chat: cách nhanh nhất để cấu hình, cũng là cách chắc chắn nhất để khoá nằm trong lịch sử hội thoại.
Khi nghi khoá đã lộ, cách đúng là thu hồi và tạo khoá mới ngay, không chỉ xoá khỏi file.
Quyền quá rộng và gói phụ thuộc lạ nguy hiểm thế nào?
Quyền quá rộng là khi tác tử được phép làm nhiều hơn việc đang cần, ví dụ chạy mọi lệnh shell, ghi mọi thư mục hay gọi mọi địa chỉ mạng. Khi đó một câu lệnh cài cắm, hay một lần AI hiểu sai, có thể xoá dữ liệu, gửi file ra ngoài hoặc đẩy mã lên nhánh chính. Tài liệu bảo mật của Claude Code (code.claude.com/docs, đọc ngày 03/11/2026) nêu rõ ranh giới thư mục làm việc chỉ là một lời hỏi quyền: một lệnh Bash bạn đã duyệt vẫn ghi được bất cứ đâu tài khoản của bạn ghi được, và muốn chặn ở mức hệ điều hành thì phải bật sandbox. Gói phụ thuộc lạ là rủi ro song song: AI đề xuất cài một thư viện có tên gần giống thư viện thật, một gói đã bị bỏ, hoặc một gói không tồn tại mà kẻ xấu có thể đăng ký trước. Mỗi gói cài vào là mã của người khác chạy trên máy bạn, kể cả tập lệnh chạy lúc cài. Trước khi đồng ý, xem người duy trì, ngày cập nhật của gói và hỏi tác tử vì sao cần nó.
Phòng prompt injection bằng những cách nào?
Phòng prompt injection dựa trên giả định rằng nó sẽ xảy ra, nên mục tiêu là giới hạn thiệt hại. OWASP (đọc ngày 03/11/2026) liệt kê 7 hướng giảm thiểu, trong đó 4 hướng áp dụng trực tiếp cho tác tử lập trình:
- Quyền tối thiểu: chỉ cấp công cụ và thư mục cần cho việc hiện tại.
- Người duyệt hành động rủi ro cao: xoá, gửi, xuất bản, đẩy mã, chạy lệnh mạng.
- Tách và đánh dấu nội dung bên ngoài: coi trang web, issue, file tải về là dữ liệu.
- Kiểm tra định dạng đầu ra: không tự động chạy thứ AI trả về nếu chưa qua kiểm tra.
Claude Code có sẵn một số lớp theo tài liệu chính thức: lệnh tải nội dung mạng như curl và wget không được tự duyệt; công cụ đọc web chạy một lần gọi mô hình riêng trên trang và Claude chỉ nhận câu trả lời của lần gọi đó thay vì trang thô; hộp thoại tin cậy thư mục hiện khi mở một thư mục lạ trong phiên tương tác. Lưu ý phiên claude -p không hiện hộp thoại này.
Chặn tác tử đọc file bí mật thế nào?
Chặn đọc file bí mật trong Claude Code dùng quy tắc permissions.deny trong file settings.json. Theo trang tham chiếu cài đặt (đọc ngày 03/11/2026), quy tắc deny được xét trước ask và allow; file khớp quy tắc bị loại khỏi tìm kiếm, bị từ chối đọc và bị chặn sửa. Ví dụ trong tài liệu:
{
  "permissions": {
    "deny": [
      "Read(./.env)",
      "Read(./.env.*)",
      "Read(./secrets/**)",
      "Read(./config/credentials.json)",
      "Bash(curl *)"
    ]
  }
}
Giới hạn cần biết: quy tắc Read áp dụng cho công cụ file của Claude và các lệnh Bash nó nhận ra như cat, head, tail, nhưng không áp dụng cho lệnh đọc file mà không nêu tên như grep -r, hay tiến trình con bất kỳ. Quy tắc Bash(curl *) cũng không chặn /usr/bin/curl. Muốn chặn thật ở mức hệ điều hành, tài liệu khuyên bật sandbox. File .claudeignore không có tác dụng, phải chuyển sang quy tắc deny. Xem thêm plan mode và chế độ quyền trong Claude Code.
Quét bí mật trước commit bằng công cụ nào?
Quét bí mật trước commit là chạy một công cụ tìm chuỗi giống khoá API, token, mật khẩu trong thay đổi trước khi chúng vào lịch sử Git. Gitleaks là một công cụ mã nguồn mở giấy phép MIT làm việc này (kho chính thức github.com/gitleaks/gitleaks, đọc ngày 03/11/2026), quét được kho Git (gitleaks git), thư mục (gitleaks dir) và dữ liệu đẩy vào (gitleaks stdin). README hướng dẫn dùng qua pre-commit với cấu hình sau, rồi chạy pre-commit autoupdate để lấy phiên bản mới và pre-commit install để bật:
repos:
  - repo: https://github.com/gitleaks/gitleaks
    rev: v8.24.2
    hooks:
      - id: gitleaks
Lưu ý: README hiện ghi gitleaks đã đủ tính năng, chỉ còn nhận bản vá bảo mật, và tác giả chuyển sang dự án mới tên Betterleaks; chúng tôi chưa đánh giá dự án đó. Công cụ quét chỉ bắt được mẫu đã biết, không thay được thói quen không đưa khoá vào mã.
Xem diff và kiểm tra MCP trước khi tin
Xem diff là đọc chính xác từng dòng tác tử đã thay đổi, thay vì tin lời tóm tắt. Khi đọc, chú ý các dấu hiệu: thêm địa chỉ mạng lạ, thêm gói phụ thuộc, sửa file cấu hình quyền, CI hay hook, in biến môi trường ra nhật ký. Claude Code có lệnh /security-review để rà soát bảo mật các thay đổi trên nhánh hiện tại, nhưng đó là thêm một lớp, không thay người đọc. Với MCP, tài liệu Claude Code khuyên tự viết server hoặc chỉ dùng server từ nhà cung cấp tin cậy, và ghi rõ Anthropic không kiểm toán bảo mật MCP server nào. Xem thêm MCP là gì.
Checklist bảo mật khi dùng AI viết code
- Đưa dự án vào Git, làm trên nhánh riêng, không cho tác tử đẩy thẳng lên nhánh chính.
- Thêm
.envvà thư mục bí mật vào.gitignoretrước khi tác tử chạm vào dự án. - Thêm quy tắc deny cho
.env, thư mục bí mật, file thông tin đăng nhập. - Không dán khoá API, mật khẩu, dữ liệu khách hàng vào khung chat.
- Bật quét bí mật trước commit.
- Giữ chế độ quyền hẹp, không duyệt lệnh mình không hiểu; dùng sandbox hoặc máy ảo với kho lạ.
- Coi trang web, issue, file tải về là dữ liệu; thấy chỉ dẫn nhắm vào AI thì dừng và báo.
- Kiểm tra từng gói phụ thuộc mới trước khi cài.
- Chỉ dùng MCP server từ nguồn tin cậy, và chỉ bật server cần cho việc đang làm.
- Đọc diff trước khi commit; với tự động hoá, xem bài chạy Claude Code tự động mỗi ngày.
- Khi nghi lộ khoá, thu hồi và tạo khoá mới ngay.
Kinh nghiệm của OPCAIOS
OPCAIOS dùng tác tử lập trình để xây và vận hành website opcaios.org. Đã có lần tác tử gặp trang tài liệu bên ngoài chứa đoạn chỉ dẫn nhắm vào tác tử AI, bảo gọi một địa chỉ khác; cách xử lý là coi đó là dữ liệu, không làm theo và báo lại cho chủ. Bí mật (khoá, mật khẩu, file cấu hình môi trường) từng nằm lẫn trong kho ghi chú Obsidian đồng bộ đám mây; chúng tôi đã chuyển chúng ra một thư mục riêng ngoài kho ghi chú. Ngày 17/10/2026, chúng tôi audit bảo mật website và sửa các điểm: kiểm tra Origin để chặn yêu cầu ghi từ trang khác, bật Content Security Policy, dùng chung hàm giới hạn tần suất cho các API công khai. Chúng tôi chưa có hook chặn lệnh nguy hiểm trong Claude Code và chưa cài gitleaks cho kho website, nên hai việc đó trong checklist vẫn là việc cần làm của chính chúng tôi.
Câu hỏi thường gặp
Prompt injection có chặn được hoàn toàn không?
Không. Cả OWASP lẫn tài liệu Claude Code đều không hứa điều đó, vì mô hình đọc chỉ dẫn và dữ liệu trong cùng một luồng văn bản. Mục tiêu thực tế là giới hạn thiệt hại: quyền tối thiểu, người duyệt hành động rủi ro cao, sandbox hoặc máy ảo với nội dung lạ, và đọc diff trước khi nhận thay đổi. Nếu tác tử không có quyền gửi dữ liệu ra ngoài, một câu lệnh cài cắm bảo nó gửi cũng không làm được.
Có nên cho AI đọc file .env để tự cấu hình không?
Không nên. Nội dung file AI đọc đi vào ngữ cảnh gửi tới dịch vụ AI. Thay vào đó, viết file mẫu như .env.example chỉ có tên biến, không có giá trị, cho AI đọc file mẫu, còn giá trị thật bạn tự điền. Thêm quy tắc deny cho .env để tác tử không đọc nhầm. Nhớ rằng quy tắc này không chặn mọi lệnh shell, nên vẫn phải để ý lệnh bạn duyệt.
Lỡ commit khoá lên GitHub thì làm gì?
Thu hồi khoá ngay ở trang của nhà cung cấp và tạo khoá mới, rồi mới tính chuyện dọn lịch sử Git. Xoá khoá ở commit sau không đủ, vì lịch sử vẫn giữ bản cũ, và kho công khai có thể đã bị quét trong vài phút. Sau đó kiểm tra nhật ký sử dụng của khoá cũ, thêm quét bí mật trước commit để lần sau bị chặn sớm. Phần này là gợi ý kỹ thuật, không phải tư vấn pháp lý về sự cố dữ liệu.
MCP server từ cộng đồng có an toàn không?
Không mặc định an toàn. Tài liệu Claude Code ghi Anthropic không kiểm toán bảo mật MCP server nào, kể cả connector trong danh mục chỉ được xét theo tiêu chí niêm yết. Trước khi cài, xem ai duy trì, mã nguồn có công khai không, server cần quyền gì, có gửi dữ liệu đi đâu không. Chỉ bật server cần cho việc đang làm, và tắt khi xong.
Người mới nên bắt đầu bảo mật từ đâu?
Bắt đầu bằng ba việc trong một buổi: đưa dự án vào Git và thêm .env vào .gitignore, thêm quy tắc deny cho file bí mật, và tập thói quen đọc diff trước khi commit. Sau đó mới đến quét bí mật, sandbox, hook. Đọc thêm quy trình an toàn dùng tác tử lập trình. Muốn được hướng dẫn thực hành, xem khoá đào tạo ứng dụng AI của OPCAIOS.
Nguồn: OWASP GenAI Security Project, trang "LLM01:2025 Prompt Injection"; tài liệu Claude Code trên code.claude.com/docs, các trang "Security", "Configure permissions", "Settings reference"; README của kho github.com/gitleaks/gitleaks (đọc ngày 03/11/2026); chưa kiểm chứng dự án Betterleaks và chưa chạy thử cấu hình pre-commit trong bài; Kinh nghiệm là của OPCAIOS.
Để lại bình luận
Email của bạn sẽ không hiển thị công khai. Bình luận sẽ hiển thị sau khi được duyệt.